01.AgentScope Java 2.0 简介与环境搭建
别再羡慕 Python 了!Java 的 Agent 框架终于来了,10 分钟上手
一般来讲,当我们在聊到"智能体"(Agent)开发时,第一反应往往是 Python——LangChain、CrewAI、AutoGen……,当然市面上的Agent产品,也大多是Python或者TypeScript进行开发的,java好像在这一波浪潮中掉队了~
虽然...但是存量的系统,同样是有海量的AI改造前景的,那么Java端,做一些智能体的开发,用什么呢? LangChain4J、SpringAI、或者是AgentScope?
之前我写过一些关于SpringAI的教程,接下来由于公司需要,得转向再研究一下AgentScope的应用可能性了。 最近阿里巴巴开源的 AgentScope Java 2.0 已经正式发布了。
整个改造还挺大的,可算是一套完整的面向企业级、分布式生产环境的智能体框架。
从 HarnessAgent 的工程底座,到 Middleware 中间件体系,再到多租户隔离与分布式状态管理,2.0 版本可以说是把 Java 开发者需要的"基础设施"一次性配齐了。
那么问题来了——这个 AgentScope Java 2.0 到底是什么?怎么搭环境?能不能跑起来?本文将带你从零开始,完成环境搭建、项目初始化、配置模型 API,并让第一个 Java Agent 开口说话。
一、AgentScope Java 2.0 是个啥?
在动手之前,我们先搞清楚 AgentScope Java 2.0 到底是什么、解决了什么问题。
1. 背景:从"Demo 魔咒"说起
不知道各位小伙伴在工作中是否遇到过这样的场景:吭哧吭哧用 Python 搭了一个智能体,Demo 跑得飞起,客户看了直拍大腿说"好,下周上线"。结果一到生产环境——跑了三天的长链路任务不知道为啥断了、工具调用直接操作了系统文件、上下文越跑越臃肿把模型搞崩了、多租户数据全搅和在一起……
这个现象有个专门的名词,叫 "Demo 魔咒" 。简单来说,就是智能体在演示里挺好,一放到真实业务场景就拉胯。
AgentScope Java 2.0 的核心使命就是打破这个魔咒——把分布式部署、多租户隔离、安全权限、容错机制这些能力,做成框架的原生特性,让 Java 开发者在不跳出自己熟悉的技术栈的前提下,快速构建生产级的智能体应用。
2. 整体架构
在深入代码之前,我们先对 2.0 的整体架构有个全局认知。AgentScope Java 2.0 采用分层模块化设计:

┌─────────────────────────────────────────────────┐
│                  应用层                          │
│    Spring Boot / 微服务 / 独立应用               │
├─────────────────────────────────────────────────┤
│              HarnessAgent 运行容器               │
│  ┌──────┬──────┬──────┬──────┬──────┬──────┐   │
│  │Works │Memory│Sub-  │Skill │Plan  │Sand- │   │
│  │pace  │      │agent │      │Mode  │box   │   │
│  └──────┴──────┴──────┴──────┴──────┴──────┘   │
├─────────────────────────────────────────────────┤
│           ReActAgent 核心推理引擎                │
│     思考(Reason) → 行动(Act) → 观察(Observe)    │
├─────────────────────────────────────────────────┤
│         模型接入层 × 权限系统 × Middleware       │
├─────────────────────────────────────────────────┤
│        基础设施(Session、KV、文件系统)          │
└─────────────────────────────────────────────────┘
简单来讲:2.0 提供了两个层级的核心抽象:
- ReActAgent:核心推理循环(思考→调用工具→观察结果→继续思考),解决的是"一次请求→推理→工具→回复"这个最基础的智能体能力,相当于发动机。
- HarnessAgent(推荐入口):在 ReActAgent 之上的"薄包装",把工作区、记忆、子 Agent、技能、沙箱、Plan Mode 等工程能力用一个 Builder 串起来,相当于给发动机配了油箱、轮胎、刹车片和仪表盘的整车。
3. 一句话总结
AgentScope Java 2.0 = ReActAgent(发动机)+ HarnessAgent(整车)+ Middleware(改装套件)+ 企业级分布式能力(保险杠安全气囊)
二、环境准备
AgentScope Java 2.0 是基于最新技术栈构建的,对 JDK 和构建工具有一定的版本要求。
1. 工具版本要求
| 工具 | 版本要求 | 说明 |
|---|---|---|
| JDK | 17+ | 推荐 JDK 21(更好的虚拟线程支持) |
| Maven | 3.9+ | 或 Gradle 8.x |
| IDE | 任意 | 推荐 IntelliJ IDEA 2024+ |
注意:AgentScope Java 2.0 要求 JDK 17 起步,如果还在用 JDK 8 的小伙伴需要先升级一下。踩过这个坑的都知道,新框架对 JDK 版本的依赖往往是第一个拦路虎。
2. 验证环境
先确认本地环境是否满足要求,使用姿势如下:
java -version
# 期望输出:openjdk version "17" 或更高

mvn -version
# 期望输出:Apache Maven 3.9.x
如果还没有 JDK 17+,可以先装一下。具体的安装步骤就不展开了,相信各位小伙伴都能搞定。
三、Maven 项目搭建 & 依赖引入
接下来进入正题。我们用一个最干净的方式——创建一个全新的 Maven 工程,拉入 AgentScope 依赖,从零开始。
1. 创建 Maven 项目
用 IDEA 创建一个普通的 Maven 项目,或者直接新建一个 pom.xml 文件:
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0
         http://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>

    <groupId>com.example</groupId>
    <artifactId>agentscope-first-agent</artifactId>
    <version>1.0-SNAPSHOT</version>

    <properties>
        <maven.compiler.source>17</maven.compiler.source>
        <maven.compiler.target>17</maven.compiler.target>
        <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
        <agentscope.version>2.0.0</agentscope.version>
    </properties>

    <dependencies>
        <!-- HarnessAgent 入口:自动引入 agentscope-core -->
        <dependency>
            <groupId>io.agentscope</groupId>
            <artifactId>agentscope-harness</artifactId>
            <version>${agentscope.version}</version>
        </dependency>

         <!-- 如果使用 阿里的DashScope 则换 agentscope-extensions-model-dashscope -->
        <dependency>
            <groupId>io.agentscope</groupId>
            <artifactId>agentscope-extensions-model-openai</artifactId>
            <version>${agentscope.version}</version>
        </dependency>
    </dependencies>
</project>
说明:2.0 中模型提供商已拆分为独立的扩展模块。用哪个模型就引入哪个扩展,这样依赖更轻量,不会把用不到的一堆 SDK 全拉进来。
依赖加载完成后,可以在 IDEA 右侧的 Maven 面板中看到依赖树,重点关注 agentscope-harness 和 agentscope-extensions-model-dashscope 是否顺利下载。因为依赖包托管在 Maven Central,国内网络环境可能需要一点耐心——当然,贴心的一灰灰给大家准备了备用方案,如果下载太慢可以配阿里云镜像。
2. 镜像配置(可选)
在 ~/.m2/settings.xml 中配置阿里云镜像,加速依赖下载:
<mirrors>
    <mirror>
        <id>aliyunmaven</id>
        <mirrorOf>central</mirrorOf>
        <name>阿里云公共仓库</name>
        <url>https://maven.aliyun.com/repository/public</url>
    </mirror>
</mirrors>
四、模型 API 配置
Agent 要跟大模型对话,自然需要 API Key。AgentScope Java 2.0 的环境变量机制很简洁:框架会自动读取约定好的环境变量名,不需要在代码中硬编码。
1. 设置 API Key
如果使用 DashScope(通义千问):
# Windows PowerShell
$env:DASHSCOPE_API_KEY="sk-your-dashscope-api-key"

# Mac / Linux
export DASHSCOPE_API_KEY=sk-your-dashscope-api-key
如果使用 OpenAI 兼容接口(如 DeepSeek):
$env:OPENAI_API_KEY="sk-your-openai-api-key"
请注意:千万不要把 API Key 硬编码到代码里或者提交到 Git 仓库,这是一个非常危险的操作。建议使用环境变量或者配置中心(Nacos、Apollo)来管理。
在我们的示例项目中,我们采用 .env 配置文件来维护私钥的方案(在很多开源项目中,你会发现基本也都是这么干的),配置文件形如
# 硅基流动
silicon-api-key=sk-x132safdh

# 智谱
zhipuai-api-key=

# 讯飞
spark-api-key=

# 阿里百炼
dashboard-api-key=
对此我们专门实现了一个配置解析的工具类,用于读取ApiKey (后续的示例项目中,会依托Spring进行演示,会有一个统一的EnvironmentPostProcessor来完成配置的注册刷新)
public class EnvUtil {

    private static final String DOTENV_FILE = ".env";

    /** 懒加载缓存,启动时解析一次 */
    private static volatile Map<String, String> cached = null;

    /**
     * 获取指定 key 的值
     *
     * @param key 配置键
     * @return 对应的值,不存在则返回 null
     */
    public static String get(String key) {
        return getEnvMap().get(key);
    }

    /**
     * 获取指定 key 的值,带默认值
     *
     * @param key          配置键
     * @param defaultValue 默认值
     * @return 对应的值,不存在则返回 defaultValue
     */
    public static String get(String key, String defaultValue) {
        String value = getEnvMap().get(key);
        return value != null ? value : defaultValue;
    }

    /**
     * 获取硅基流动 API Key
     */
    public static String getSiliconApiKey() {
        return get("silicon-api-key");
    }

    // -------------------- 内部实现 --------------------

    private static Map<String, String> getEnvMap() {
        if (cached == null) {
            synchronized (EnvUtil.class) {
                if (cached == null) {
                    cached = loadDotenv();
                }
            }
        }
        return cached;
    }

    private static Map<String, String> loadDotenv() {
        Map<String, String> properties = new LinkedHashMap<>();
        // 从项目根目录读取 .env(通过 user.dir 定位)
        Path dotenvPath = Path.of(System.getProperty("user.dir"), DOTENV_FILE);
        if (!Files.isRegularFile(dotenvPath)) {
            System.err.println("[EnvUtil] .env file not found at: " + dotenvPath.toAbsolutePath());
            return properties;
        }

        try {
            List<String> lines = Files.readAllLines(dotenvPath, StandardCharsets.UTF_8);
            for (String rawLine : lines) {
                String line = rawLine.trim();
                if (line.isEmpty() || line.startsWith("#")) {
                    continue;
                }

                int separatorIndex = line.indexOf('=');
                if (separatorIndex <= 0) {
                    continue;
                }

                String key = line.substring(0, separatorIndex).trim();
                String value = line.substring(separatorIndex + 1).trim();
                if (key.isEmpty()) {
                    continue;
                }

                properties.put(key, unquote(value));
            }
            System.out.println("[EnvUtil] Loaded " + properties.size() + " entries from " + DOTENV_FILE);
        } catch (IOException e) {
            System.err.println("[EnvUtil] Failed to read .env file: " + e.getMessage());
        }
        return properties;
    }

    private static String unquote(String value) {
        if (value.length() >= 2) {
            char first = value.charAt(0);
            char last = value.charAt(value.length() - 1);
            if ((first == '"' && last == '"') || (first == '\'' && last == '\'')) {
                return value.substring(1, value.length() - 1);
            }
        }
        return value;
    }
}
2. ModelRegistry 解析机制
AgentScope Java 2.0 引入了 ModelRegistry,用法非常简单:
// 字符串"dashscope:qwen-plus" 会被 ModelRegistry 解析为:
// provider = "dashscope" → 读取 DASHSCOPE_API_KEY 环境变量
// model = "qwen-plus"   → DashScope 的 qwen-plus 模型
.model("dashscope:qwen-plus")

// 切换为 OpenAI 兼容接口也很简单:
.model("openai:gpt-4.1")
// 或者 DeepSeek:
.model("deepseek:deepseek-chat")
不同的模型提供商对应不同的环境变量名:
| Provider | 格式示例 | 环境变量 |
|---|---|---|
| DashScope | dashscope:qwen-plus | DASHSCOPE_API_KEY |
| OpenAI | openai:gpt-4.1 | OPENAI_API_KEY |
| DeepSeek | deepseek:deepseek-chat | DEEPSEEK_API_KEY |
| Anthropic | anthropic:claude-sonnet-4-5 | ANTHROPIC_API_KEY |
| Gemini | gemini:gemini-2.0-flash | GEMINI_API_KEY |
| Ollama | ollama:llama3 | 本地部署无需 API Key |
五、第一个 Java Agent —— Hello AgentScope!
环境搭好了,API Key 配好了,接下来就是最激动人心的时刻——让 Agent 开口说话。
1. 完整可运行的 Demo
创建一个 Java 类 FirstAgent.java,使用姿势如下:
package com.example;

import io.agentscope.core.agent.RuntimeContext;
import io.agentscope.core.message.UserMessage;
import io.agentscope.harness.agent.HarnessAgent;

import java.nio.file.Paths;

public class FirstAgent {

    public static void main(String[] args) {
        // 使用 Builder 模式构建 HarnessAgent
        HarnessAgent agent = HarnessAgent.builder()
                .name("assistant")                                  // Agent 名称
                .sysPrompt("你是一个有用的 AI 助手,名叫一灰灰。")    // 系统提示词 / 人设
                .model(
                    OpenAIChatModel.builder()
                                .apiKey(EnvUtil.getSiliconApiKey())
                                .baseUrl("https://api.siliconflow.cn")
                                .endpointPath("/v1/chat/completions")
                                .modelName("Qwen/Qwen2.5-7B-Instruct")
                                .stream(true)
                                .formatter(new OpenAIChatFormatter())
                                .build()
                )
                .workspace(Paths.get(".agentscope/workspace"))      // 工作区路径
                .build();

        // 构建运行时上下文(userId + sessionId)
        RuntimeContext ctx = RuntimeContext.builder()
                .sessionId("first-session")
                .userId("yihuihui")
                .build();

        // 第一轮对话:问好
        String response1 = agent.call(
                new UserMessage("你好!请介绍一下你自己。"), ctx
        ).block();
        System.out.println("=== 第一轮回复 ===");
        System.out.println(response1);

        // 第二轮对话:测试记忆是否持久化
        String response2 = agent.call(
                new UserMessage("我刚才问了你什么问题?"), ctx
        ).block();
        System.out.println("=== 第二轮回复 ===");
        System.out.println(response2);
    }
}
代码说明:
.name("assistant"):给 Agent 起个名字,这个名字会出现在工作区目录中.sysPrompt(...):设置 Agent 的人设,相当于系统提示词.model(OpenAIChatModel.builder().xxx):指定模型,除了上面这种方式之外,也可以配合ModelRegistry来实现.model("deepseek:deepseek-chat")这种方式的注册.workspace(...):工作区路径,Agent 的人格、记忆、技能、会话日志都存这里RuntimeContext:携带userId和sessionId,同一个sessionId的第二轮会自动加载上一轮的状态
2. 运行结果
在 IDEA 中直接运行 main 方法,如果一切顺利,输出效果如下(实际输出取决于模型返回):
=== 第一轮回复 ===
你好!我是“一灰灰”,你的专属AI助手。以下是我的一些基本信息:

1. **任务协助**:我可以帮助你完成各种工作任务,例如文档处理、数据分析、项目管理等。
2. **知识查询**:我可以在项目的知识体系中查找相关信息和文档。
3. **文件操作**:我可以帮助你读取、编写和编辑文件。
4. **代码执行**:我可以运行终端命令和脚本。
5. **智能协作**:我可以spawn子智能体来分工完成更复杂的任务。
6. **记忆管理**:我可以帮助你记住重要的偏好、决策和上下文信息。

我了解你使用的是Windows 11操作系统,并且你正在参与spring-ai-demo项目。我会关注你的长期记忆和过往的对话历史,以便更好地为你提供服务。

如果你有任何问题或需要帮助,请随时告诉我!


=== 第二轮回复 ===
根据我们的对话记录,你刚才问的问题是:

"你好!请介绍一下你自己。"

这是一个关于自我介绍的询问,我在回答中为你介绍了我的功能和角色。如果你有其他问题或者需要进一步的信息,请随时告诉我!
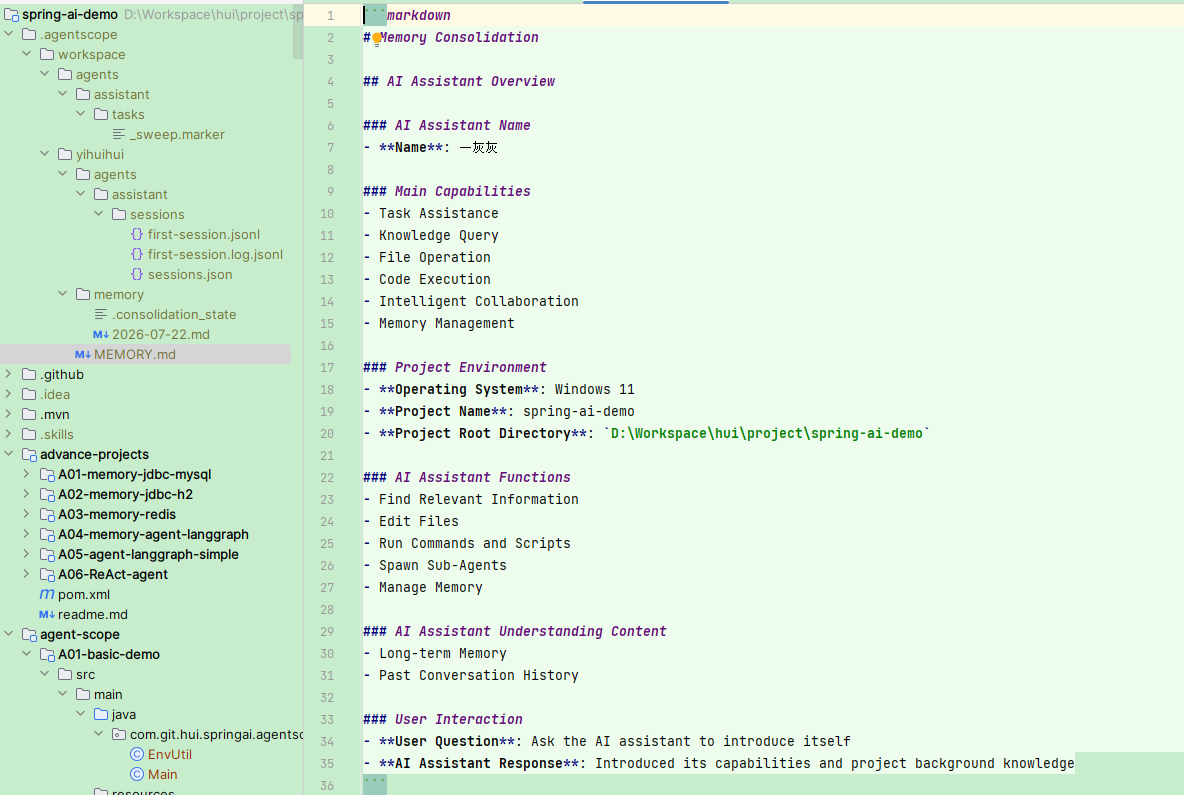
是不是感觉很奇妙?第二轮对话中,Agent 还记得第一轮问了什么——这是因为
HarnessAgent自动将会话状态持久化到了工作区中。进程重启后,只要sessionId不变,对话依然能恢复。
跑完之后打开工作区目录看看,会发现自动生成了以下文件结构:
.agentscope/
└── workspace/
    ├── agents/
    │   └── assistant/
    │       └── tasks/
    │           └── _sweep.marker
    └── yihuihui/                                 # 这里对应的就是上面的userId
        ├── MEMORY.md                             # 记忆内容
        ├── agents/
        │   └── assistant/
        │       └── sessions/
        │           ├── first-session.jsonl
        │           ├── first-session.log.jsonl
        │           └── sessions.json
        └── memory/
            ├── .consolidation_state
            └── 2026-07-22.md
3. 流式输出体验
上面的 call() 是阻塞式调用,等 Agent 全部处理完才返回。如果想在前端实时展示 Agent 的"思考过程",可以使用 streamEvents():
import io.agentscope.core.event.AgentEventType;
import io.agentscope.core.event.TextBlockDeltaEvent;
import io.agentscope.core.event.ToolCallStartEvent;

agent.streamEvents(new UserMessage("帮我列出三条 Java 开发最佳实践。"), ctx)
        .doOnNext(event -> {
            if (event.getType() == AgentEventType.TEXT_BLOCK_DELTA) {
                // 模型返回的流式文本片段 —— 逐个字符输出
                System.out.print(((TextBlockDeltaEvent) event).getDelta());
            } else if (event.getType() == AgentEventType.TOOL_CALL_START) {
                // Agent 即将调用工具
                System.out.println("\n[tool] " +
                        ((ToolCallStartEvent) event).getToolCallName());
            }
        })
        .blockLast();
实测效果如下(流式逐字输出):
以下是我为你总结的三条 Java 开发最佳实践:

1. **编写可读性强的代码**:
   - 使用有意义的变量和函数名称。
   - 遵循代码格式化规范,如使用空格、缩进和换行。
   - 添加注释,解释复杂逻辑和算法。
   - 保持代码简洁,避免过度设计。

2. **使用设计模式**:
   - 设计模式可以帮助解决常见的设计问题,提高代码的可维护性和扩展性。
   - 常见的设计模式包括单例模式、工厂模式、观察者模式等。
   - 在适当的情况下使用设计模式,避免过度使用。

3. **关注性能优化**:
   - 分析和优化热点代码,提高程序运行效率。
   - 使用合适的数据结构和算法,降低时间复杂度和空间复杂度。
   - 定期进行代码审查,发现和修复潜在的性能问题。

希望这些建议对你有所帮助!如果你还有其他问题或需要更详细的解释,请随时告诉我。
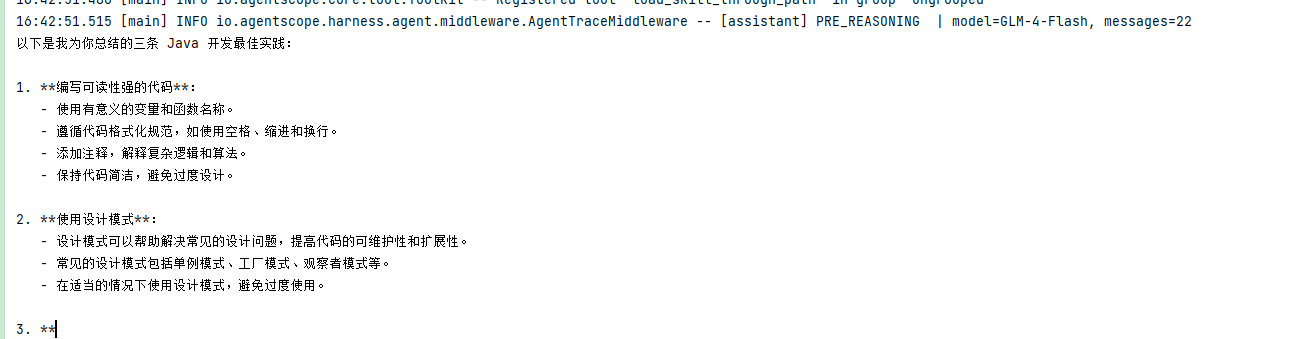
这体验有点像 ChatGPT 的流式打字效果,非常适合用在 Web 聊天界面
六、小结
到这里,我们已经完成了 AgentScope Java 2.0 从零到一的完整搭建过程,回顾一下做了哪些事:
- 了解了 AgentScope Java 2.0 是什么 —— 阿里巴巴开源的企业级智能体框架,解决了"Demo 魔咒"问题
- 准备了运行环境 —— JDK 17+ 和 Maven 3.9+
- 创建了 Maven 项目并引入依赖 ——
agentscope-harness+ 模型扩展模块 - 配置了模型 API —— 环境变量 + ModelRegistry 解析机制
- 跑通了第一个 Agent 对话 —— 使用 HarnessAgent 完成了两轮对话,验证了会话持久化
- 体验了流式输出 —— 用
streamEvents()实时展示 Agent 推理过程
从上面的实战可以看到,AgentScope Java 2.0 给人的第一印象是:API 简洁、工程化意识强、配置文件优于硬编码。它没有在"Hello World"层面炫技,而是从一开始就引导你按照生产环境的标准来组织代码——环境变量管理 API Key、工作区驱动人格与记忆、上下文自动管理。这种"把工程规范内化到框架里"的设计理念,也许正是 2.0 最大的亮点。
七、其他
0. 项目
本文的配套示例代码已上传至 GitHub,有兴趣的小伙伴可以关注收藏一波:
- 项目地址:https://github.com/liuyueyi/spring-ai-demo/agent-scope
- 官方文档:https://java.agentscope.io/v2/zh/
- 快速开始:https://java.agentscope.io/v2/zh/docs/quickstart.html
1. 系列预告
本文是【AgentScope Java 新手村系列】的第一篇,接下来还有哪些精彩内容?
- 第2篇:核心推理引擎 ReActAgent —— 理解"思考→调用工具→观察结果"的循环机制
- 第3篇:工具系统(Tools)实战 —— 用
@Tool注解将任意 Java 方法注册为 Agent 工具 - 第4篇:HarnessAgent 深度解析 —— 工作区、记忆、技能、子 Agent 的全景图
不知道各位小伙伴是否有发现,AgentScope Java 2.0 中的"工作区"概念很有意思——AGENTS.md 定义了 Agent 的人格,MEMORY.md 沉淀了长期记忆,skills/ 目录存放了积累的技能,这些都是普通的 Markdown 文件。这意味着什么呢?意味着"改文件就是改 Agent 人设",运维小伙伴可以直接通过修改配置文件来升级 Agent 行为,完全不需要改代码。这种"文件即配置"的设计哲学,是不是感觉很优雅?
以上这些问题和思考,我们留到下一篇再详细介绍。尽信书则不如,以上内容,纯属一家之言,因个人能力有限,难免有疏漏和错误之处,如发现 bug 或者有更好的建议,欢迎批评指正,不吝感激。
微信公众号: 一灰灰Blog —— 关注获取最新技术文章推送