03.AgentScope Java 2.0 你的第一个 Java Agent:使用 Builder 模式构建基础对话机器人,开启流式输出与思考模式
纯 Java 构建 AI 对话机器人:AgentScope 2.0 Builder 模式与流式输出实战
同样的 Builder 链,能搭出"一问一答"的哑巴,也能搭出"边说边想"的智者——区别只在于你开了哪几个开关
你的第一个 Java Agent:Builder 模式、流式输出与思考模式完全指南
前两篇文章我们完成了环境搭建,也拆解了 ReActAgent 的核心推理循环。但有个细节不知道各位小伙伴注意到没有——无论是 ReActAgent 还是 HarnessAgent,创建方式都用的是 Builder 模式。
// 你看,两种 Agent 都是 builder()
HarnessAgent agent = HarnessAgent.builder()
        .name("assistant")
        .model(...)
        .workspace(...)
        .build();

ReActAgent agent = ReActAgent.builder()
        .name("weather-agent")
        .sysPrompt("...")
        .model(...)
        .toolkit(...)
        .build();
那么问题来了——为什么 AgentScope 2.0 选择了 Builder 模式,而不是构造函数、配置文件或者 Spring Bean?Builder 模式到底好在哪?怎么用 Builder 搭出一个"能说会道还会思考"的对话机器人?
今天这篇文章就彻底搞懂这三件事:Builder 模式的设计哲学、流式输出的完整姿势、以及思考模式(Thinking Mode)的正确打开方式。
一、先聊聊:为什么是 Builder 模式?
一般来讲,Java 开发者创建一个对象有四种常见方式:
| 方式 | 典型代码 | 问题 |
|---|---|---|
| 构造函数 | new Agent(name, model, sysPrompt, toolkit, ...) | 参数一多就晕,顺序不能错 |
| Setter 注入 | agent.setName(); agent.setModel(); | 对象可能处于"半构建"状态 |
| Spring Bean | @Bean 注入 | 太重,而且 Agent 通常是动态创建的 |
| 配置文件 | application.yml | 灵活性差,运行时难以调整 |
AgentScope 2.0 选了 Builder 模式,原因其实很简单——一个 Agent 的可配置项太多了,而且有大量的可选参数。
来看看一个完整的 HarnessAgent Builder 都有什么:
HarnessAgent agent = HarnessAgent.builder()
        // ─── 必填项 ───
        .name("agent-demo")                          // Agent 名称
        .model(model)                                // LLM 模型

        // ─── 基础可选 ───
        .sysPrompt("你是一个有用的助手。")             // 系统提示词
        .workspace(Paths.get(".workspace"))           // 工作区路径

        // ─── 记忆与上下文 ───
        .memory(MemoryConfig.builder()                // 记忆配置
                .model("openai:gpt-4.1-mini")         // 可指定轻量模型做记忆
                .build())
        .compaction(CompactionConfig.builder()        // 上下文压缩配置
                .model("openai:gpt-4.1-mini")
                .build())
        .maxContextTokens(8000)                       // MEMORY 注入预算
        .additionalContextFile("SOUL.md")             // 额外上下文文件
        .additionalContextFile("PREFERENCES.md")

        // ─── 技能与工具 ───
        .toolkit(toolkit)                             // 工具注册中心
        .skillRepository(fileSystemSkillRepository)   // 技能仓库

        // ─── 高级能力 ───
        .enablePlanMode()                             // 开启计划模式
        .planFileDirectory("plans")                   // 计划文件目录

        // ─── 中间件 ───
        .middleware(new LoggingMiddleware())           // 注册中间件

        .build();                                     // 最终构建
看到没?十几个配置项,大部分都是可选的。如果用构造函数,你得写出 N 个重载版本——这画面太美我不敢看。
而 Builder 模式的精髓就在于:
用链式调用的方式,把"我要什么"说清楚,不用关心"怎么拼起来"。
这对 Agent 框架来说尤其重要——Agent 是一个"活的"对象,它需要的不是"new 出来"的那一刻就定死一切,而是"可以灵活组合各种能力"的构造方式。Builder 模式正好满足了这种高可配、高可读、高安全性的需求。
1. 跟 Spring AI 对比一下
用过 Spring AI 的小伙伴应该知道,它的 Agent 创建方式更"Spring 化"——通过 @Bean 注入各种组件:
// Spring AI 的方式:依赖注入
@Bean
public ChatClient chatClient(ChatClient.Builder builder) {
    return builder
            .defaultSystem("你是一个助手")
            .build();
}
AgentScope 的选择是纯 Java Builder,不绑定 Spring 容器。这意味着——你可以在任何地方创建 Agent,不一定要在 Spring 上下文里。对于非 Spring 项目、或者需要动态创建 Agent 的场景来说,这个设计更轻量、更灵活。
当然,如果你项目本身就是 Spring Boot,直接把构建好的 Agent 注册为 @Bean 也完全没问题。
二、Builder 模式的核心构建块拆解
上面那张配置清单看着有点多,我们来一个个拆解。我把配置项按用途分成四个组,方便理解和记忆。
1. 基础三件套:name / model / sysPrompt
这三个是 Agent 的"身份证",缺任何一个 Agent 都跑不起来:
/**
 * name —— Agent 的身份标识
 * - 出现在工作区目录、日志、事件 source 字段中
 * - 在多 Agent 协作中用于区分不同的 Agent
 * - 建议用英文短词:assistant、coder、reviewer 等
 */
.name("assistant")

/**
 * model —— Agent 的大脑
 * - 可以是 ModelRegistry 解析的字符串:"deepseek:deepseek-chat"
 * - 也可以是直接构建的 Model 对象:OpenAIChatModel.builder()...build()
 * - 推荐用字符串方式,通过 ModelRegistry 统一管理
 */
.model("deepseek:deepseek-chat")

/**
 * sysPrompt —— Agent 的人设
 * - 系统提示词,告诉 Agent"你是谁、该怎么做"
 * - 对于 HarnessAgent,sysPrompt 是可选的(工作区里可以放 AGENTS.md)
 * - 对于 ReActAgent,sysPrompt 是必须的
 */
.sysPrompt("你是一个资深的 Java 开发工程师,擅长代码审查和性能优化。")
2. 可选但推荐:workspace / memory / toolkit
这三个"开箱即用"很爽,但配好了战斗力翻倍:
/**
 * workspace —— Agent 的"家"
 * - 工作区路径,如果不配默认为 ${user.dir}/.agentscope/workspace
 * - Agent 的人设、记忆、技能、会话日志都存这里
 * - 同一个 workspace + 同一个 userId + 同一个 sessionId → 跨会话记忆恢复
 */
.workspace(Paths.get(".agentscope/workspace"))

/**
 * memory —— Agent 的"长期记忆"
 * - 用单独的模型(通常是轻量模型)来处理记忆的存取
 * - 主模型做复杂推理,记忆模型做上下文管理——分工明确
 */
.memory(MemoryConfig.builder()
        .model("openai:gpt-4.1-mini")
        .build())

/**
 * toolkit —— Agent 的"工具箱"
 * - 注册 @Tool 注解标注的 Java 方法
 * - 也可以注册 MCP 客户端(对接外部服务)
 */
.toolkit(toolkit)
3. 进阶能力:enablePlanMode / middleware
这两个是"高手选项",让 Agent 具备规划和可观测性:
/**
 * enablePlanMode —— 让 Agent 先想后做
 * - 安装 PlanEnter / PlanExit / PlanLoad 三个元工具
 * - Agent 会在复杂任务前先写计划,确认后再执行
 * - 适合多步骤、高风险的场景
 */
.enablePlanMode()
.planFileDirectory("plans")   // 计划文件存放目录

/**
 * middleware —— Agent 的"中间件"
 * - 类似 Spring 的 Filter / Interceptor
 * - 5 个核心钩子:onAgent / onReasoning / onActing / onModelCall / onSystemPrompt
 * - 用于日志、限流、重试、监控等横切逻辑
 */
.middleware(new LoggingMiddleware())
.middleware(new RateLimitMiddleware())
在这里,简单提一下Middleware,是在不修改 agent 或 model 代码的前提下,向 agent 执行流程中的关键位置注入自定义逻辑(日志、追踪、输入改写、访问控制等)的机制。
简单来说,在我们希望对大模型的调用过程进行检测管控时,就可以通过Middleware来进行管控,这就是我们自己来控制大模型调用执行最佳控制手段。
4. 上下文增强:additionalContextFile / maxContextTokens
这两个是做"知识注入"的关键:
/**
 * additionalContextFile —— 额外上下文文件
 * - 可以是工作区相对路径的任意 Markdown 文件
 * - 内容会在每次对话时内联到系统提示词中
 * - 适合放"始终有效的背景知识"
 */
.additionalContextFile("SOUL.md")             // Agent 的"灵魂设定"
.additionalContextFile("PRODUCT_RULES.md")    // 产品规则
.additionalContextFile("CODING_STANDARDS.md") // 编码规范

/**
 * maxContextTokens —— 控制 MEMORY 注入的上限
 * - 默认值取决于模型上下文窗口
 * - 设得太小:记忆不够用;设得太大:模型被历史淹没
 * - 建议设为模型最大上下文的 60-70%
 */
.maxContextTokens(8000)
踩坑提醒:
additionalContextFile不是越多越好。每个文件都会在每次对话中注入到系统提示词里,如果文件太多太大,Token 消耗会飞速增长。建议只放 2-3 个最核心的文件,详细的技能知识通过 SkillRepository 按需加载。
三、你的第一个"真正"的对话机器人
前两篇的 demo 都是一次性运行,今天我们来构建一个可以持续对话的基础聊天机器人——支持多轮对话保持上下文、流式打字效果输出、以及实时展示思考过程。
1. 构建一个支持多轮对话的 Bot
package com.example;

import io.agentscope.core.ReActAgent;
import io.agentscope.core.message.Msg;
import io.agentscope.core.message.UserMessage;
import io.agentscope.extensions.model.openai.OpenAIChatModel;
import io.agentscope.extensions.model.openai.OpenAIChatFormatter;

import java.util.Scanner;

public class ChatBotDemo {

    public static void main(String[] args) {
        // 1. 构建模型(开启流式模式)
        OpenAIChatModel model = OpenAIChatModel.builder()
                .apiKey(EnvUtil.getSiliconApiKey())
                .baseUrl("https://api.siliconflow.cn")
                .endpointPath("/v1/chat/completions")
                .modelName("Qwen/Qwen2.5-7B-Instruct")
                .stream(true)                    // ← 流式输出开关
                .formatter(new OpenAIChatFormatter())
                .build();

        // 2. 构建 Agent(纯对话,不需要工具)
        ReActAgent agent = ReActAgent.builder()
                .name("chat-bot")
                .sysPrompt("你是一个友善、风趣的聊天伙伴。" +
                        "你会记住对话历史,基于上下文回答问题。" +
                        "回答简洁但信息量充足。")
                .model(model)
                .maxIters(3)                     // 纯对话不需要太多迭代
                .build();

        System.out.println("╔════════════════════════════════════╗");
        System.out.println("║      🤖 一灰灰聊天机器人 v1.0       ║");
        System.out.println("║  输入 'exit' 退出,输入 'clear' 清空  ║");
        System.out.println("╚════════════════════════════════════╝\n");

        // 3. 多轮对话循环
        try (Scanner scanner = new Scanner(System.in)) {
            while (true) {
                System.out.print("🙋 你: ");
                String input = scanner.nextLine().trim();

                if ("exit".equalsIgnoreCase(input)) {
                    System.out.println("👋 再见!");
                    break;
                }
                if ("clear".equalsIgnoreCase(input)) {
                    agent = ReActAgent.builder()
                            .name("chat-bot")
                            .sysPrompt("你是一个友善、风趣的聊天伙伴。" +
                                    "你会记住对话历史,基于上下文回答问题。" +
                                    "回答简洁但信息量充足。")
                            .model(model)
                            .maxIters(3)
                            .build();            // ← 重新创建 Agent 清空上下文
                    System.out.println("🧹 对话历史已清空!\n");
                    continue;
                }

                System.out.print("🤖 Bot: ");
                // 流式输出——逐字打印
                agent.streamEvents(new UserMessage(input))
                        .doOnNext(event -> {
                            if (event.getType() == AgentEventType.TEXT_BLOCK_DELTA) {
                                String delta = ((TextBlockDeltaEvent) event).getDelta();
                                System.out.print(delta);
                            }
                        })
                        .blockLast();
                System.out.println("\n");
            }
        }
    }
}
运行效果:
╔════════════════════════════════════╗
║      🤖 一灰灰聊天机器人 v1.0       ║
║  输入 'exit' 退出,输入 'clear' 清空  ║
╚════════════════════════════════════╝

🙋 你: 你好!我是第一次来聊天。
🤖 Bot: 你好!很高兴遇见你。首蓿次聊天也可以很有趣呢。有什么想聊的话题吗?

🙋 你: 我刚才说了什么?
🤖 Bot: 你刚才说你是第一次来聊天。很高兴遇见你첫번째 대화吆,注意放松哦。

🙋 你: 那你能记住我名字吗?叫一灰灰。w
🤖 Bot: 当然可以了,叫我一灰灰,很高兴认识你!有什么想聊聊的话题吗?

🙋 你: 我是谁
🤖 Bot: 你在之前的对话中说叫“一灰灰”。如果你有不同的名字,可以告诉我哦!

🙋 你: clear
🧹 对话历史已清空!

🙋 你: 你知道我叫什么吗
🤖 Bot: 你叫什么名字呢?我可以记住你的的名字哦。
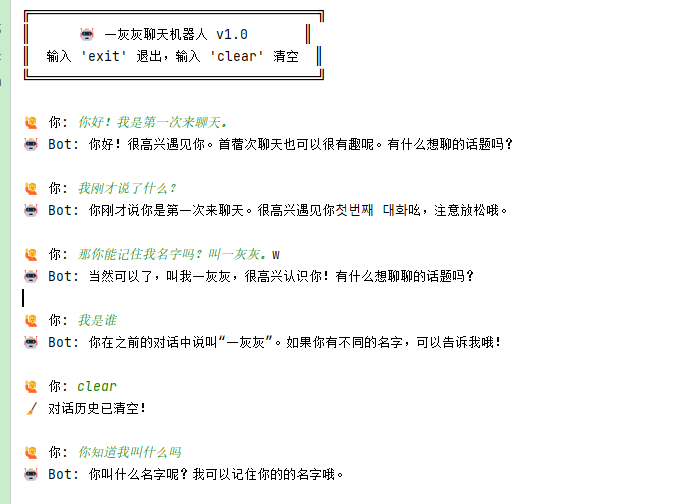
有没有发现神奇的地方?Agent 自己就记住了上下文——第二轮它记得第一轮说了什么,第三轮它记住了"一灰灰"这个名字。而"clear"之后重新构建 Agent,它就不记得之前的对话了。
这是因为 ReActAgent 的 call() 方法内部自动维护了上下文队列。每次调用时,用户消息和 Agent 回复都会追加到队列中,模型"看到"的是完整的对话历史。这也是为什么纯对话场景下 maxIters 设成 3 就够了——没有工具调用,Agent 不需要多次迭代。
2. 没有 Session 持久化的"记忆"有个坑
注意上面这个 demo,Agent 的记忆只在内存中生效——进程重启后,对话就丢了。
如果想让 Agent 跨进程重启保持记忆,需要配置 stateStore:
// HarnessAgent 的方式——工作区自动管理持久化
HarnessAgent agent = HarnessAgent.builder()
        .name("persistent-bot")
        .model(model)
        .workspace(Paths.get(".agentscope/sessions"))
        .build();

// 第二轮起,同 userId + sessionId 就会自动加载历史
String reply = agent.call(
        new UserMessage("我刚才说了什么?"),
        RuntimeContext.builder()
                .userId("yihuihui")
                .sessionId("chat-001")
                .build()
).block();
这块在上一篇讲 ReActAgent 时已经详细对比过了,这里不再赘述。
四、流式输出深入:不仅仅是"逐字打印"
前两篇文章我们都用了 streamEvents(),但只是简单处理了 TEXT_BLOCK_DELTA 事件。实际上 AgentScope 2.0 的流式事件系统远不止于此——它覆盖了 Agent 执行的整个生命周期。
1. 你需要知道的 6 类核心事件
我把最常用的六类事件整理成了下表:
| 事件类型 | 触发时机 | 典型用途 |
|---|---|---|
AgentStartEvent | Agent 开始处理请求 | 显示"思考中..."的加载状态 |
TextBlockDeltaEvent | 文本逐块生成 | 流式打字效果 |
ThinkingBlockStartEvent | 模型开始思考(思维链) | 显示"🤔 思考中..." |
ThinkingBlockDeltaEvent | 思考内容逐块生成 | 实时展示推理过程 |
ThinkingBlockEndEvent | 思考结束 | 关闭思考气泡 |
ToolCallStartEvent | Agent 决定调用工具 | 显示"🔧 正在查资料..." |
ToolResultEndEvent | 工具执行完成 | 工具结果已经返回 |
AgentEndEvent | Agent 处理完成 | 结束流式输出 |
2. 一个完整的流式监听器
把上面这些事件组合起来,就能实现"ChatGPT 级别"的流式展示效果:
agent.streamEvents(new UserMessage("介绍一下 Builder 模式的优缺点"))
        .doOnNext(event -> {
            switch (event.getType()) {
                case AGENT_START -> {
                    // Agent 开始处理
                    System.out.println("\n🤔 正在思考...");
                }
                case THINKING_BLOCK_DELTA -> {
                    // 思考过程——灰色显示思维链
                    String thought = ((ThinkingBlockDeltaEvent) event).getDelta();
                    System.out.print("\u001B[90m" + thought + "\u001B[0m"); // 灰色
                }
                case THINKING_BLOCK_END -> {
                    // 思考结束,准备输出
                    System.out.println("\n\u001B[90m━━━ 思考完毕,开始回答 ━━━\u001B[0m\n");
                }
                case TEXT_BLOCK_DELTA -> {
                    // 正式回答——正常颜色流式输出
                    System.out.print(((TextBlockDeltaEvent) event).getDelta());
                }
                case TOOL_CALL_START -> {
                    // Agent 调用工具
                    String toolName = ((ToolCallStartEvent) event).getToolCallName();
                    System.out.println("\n🔧 [调用工具] " + toolName);
                }
                case TOOL_CALL_DELTA -> {
                    // 工具执行传参
                    String toolInput = ((ToolCallDeltaEvent) event).getDelta();
                    System.out.println("➡️  参数: " + toolInput);
                }
                case TOOL_RESULT_TEXT_DELTA -> {
                    // 工具执行结果流式输出
                    String toolOutput = ((ToolResultTextDeltaEvent) event).getDelta();
                    System.out.print("➡️  返回: "+ toolOutput);
                }
                case TOOL_RESULT_END -> {
                    // 工具执行完毕
                    System.out.println("\n✅ [工具完成]");
                }
                case AGENT_END -> {
                    // 全部处理完成
                    System.out.println("\n\n✅ 完成!");
                }
                default -> {
                    // 其他事件忽略
                }
            }
        })
        .blockLast();
运行效果:
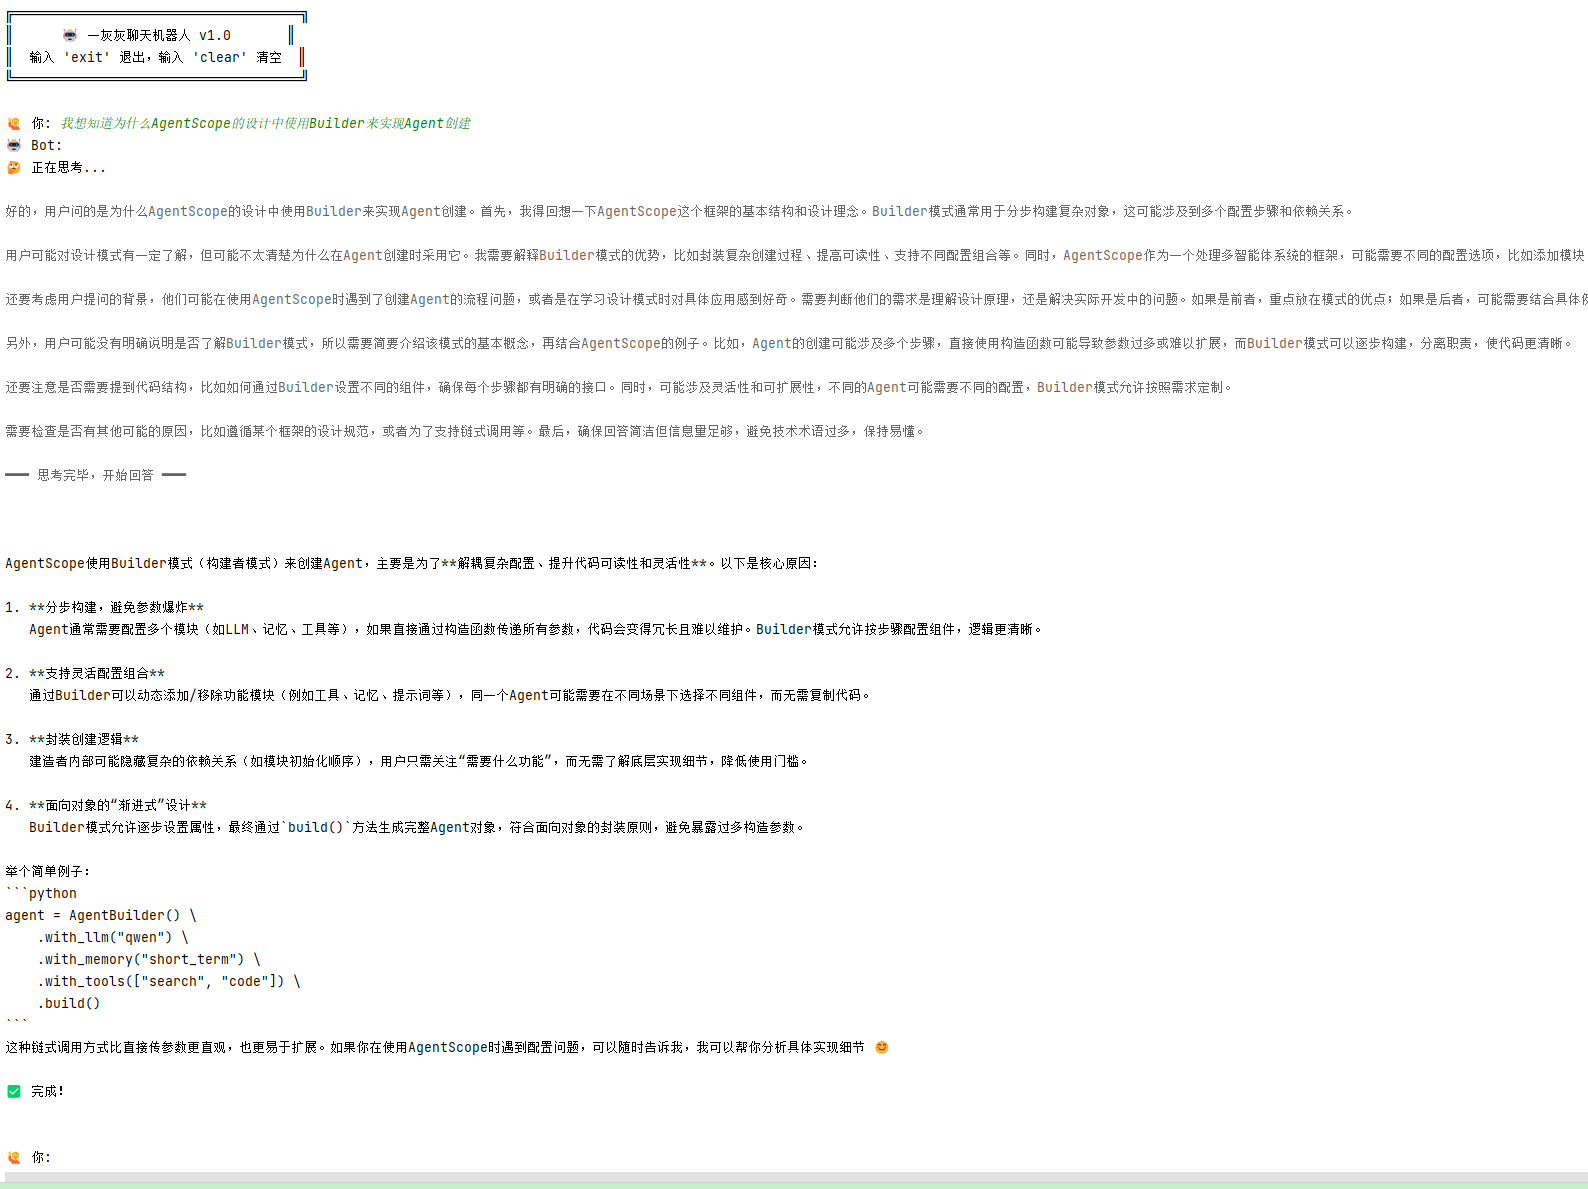
注意:上面的
THINKING_BLOCK_*事件对应的是模型的"思维链"(Chain of Thought)内容。不是所有模型都支持思维链输出——像 DeepSeek-R1、QwQ-32B 这类推理模型会输出完整的思考过程,而普通模型可能只会输出简短的中间推理。
3. 在 Web 应用中对接流式输出
如果你的 Agent 跑在 Spring Boot 后端,想把流式输出推送到前端,最简单的方式是用 WebSocket + Server-Sent Events (SSE):
// Spring Boot Controller —— SSE 端点
@GetMapping(path = "/api/chat/stream", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
public Flux<ServerSentEvent<String>> streamChat(@RequestParam String message) {
    return agent.streamEvents(new UserMessage(message))
            .map(event -> {
                String type = event.getType().name();
                String data = switch (event.getType()) {
                    case TEXT_BLOCK_DELTA -> ((TextBlockDeltaEvent) event).getDelta();
                    case THINKING_BLOCK_DELTA -> ((ThinkingBlockDeltaEvent) event).getDelta();
                    case TOOL_CALL_START -> "[工具] " +
                            ((ToolCallStartEvent) event).getToolCallName();
                    case AGENT_END -> "[DONE]";
                    default -> null;
                };
                if (data == null) return null;

                return ServerSentEvent.<String>builder()
                        .event(type.toLowerCase())
                        .data(data)
                        .build();
            })
            .filter(Objects::nonNull);
}
前端配合 EventSource 或者 fetch + ReadableStream 就能实现类似 ChatGPT 的打字效果。这块的具体实现我们放到后续"企业级工程化"章节再展开。
五、思考模式(Thinking Mode)的正确打开姿势
前面提到了 ThinkingBlock 事件,但你可能好奇——这个思考内容到底是怎么来的?是不是所有模型都能输出思考过程?怎么让 Agent 展示出"推理链"?
1. 两种"思考"的区别
在 AgentScope 2.0 中,有两层含义的"思考":
| 层面 | 对应事件 | 说明 |
|---|---|---|
| ReAct 推理循环 | ReasoningChunkEvent | Agent 框架层面的"下一步该做什么"的推理 |
| 模型思维链 | ThinkingBlock*Event | LLM 模型内部的"思考过程"(如 DeepSeek-R1 的思维链) |
简单来讲:
- ReAct 推理 = Agent 框架在循环中决定"是继续思考还是调用工具"
- 模型思维链 = LLM 在输出最终答案前,内部进行的推理过程
两者的关系可以理解为:
用户提问 → Agent 框架收到 → ReAct 循环开始
    → LLM 开始推理(思维链:ThinkingBlock 事件)
    → LLM 决定调用工具(ToolCallStart 事件)
    → 工具执行(ToolResult 事件)
    → LLM 继续推理(又一个 ThinkingBlock 事件)
    → LLM 输出最终回答(TextBlock 事件)
    → ReAct 循环结束
2. 什么时候能看到 ThinkingBlock?
关键在于模型本身是否支持思维链输出。目前主流的推理模型(reasoning models)都支持:
| 模型 | 是否输出思维链 | 备注 |
|---|---|---|
| DeepSeek-R1 | ✅ | 完整开放思维链 |
| DeepSeek-R1-Distill | ✅ | 蒸馏版也支持 |
| QwQ-32B | ✅ | 阿里通义推理模型 |
| QwQ-Plus | ✅ | 增强版 |
| GPT-4o | ⚠️ 部分 | o 系列模型有内部思维链 |
| Claude Sonnet 4.5 | ❌ | 不暴露思维链 |
| 普通模型 (Qwen2.5 等) | ⚠️ 有限 | 需要 prompt 引导 |
如果你用的是 DeepSeek-R1 这类推理模型,无需任何额外配置,streamEvents() 就会自动收到 ThinkingBlock 事件。
3. 如果模型不支持思维链?自己动手造一个
如果你用的是 Qwen2.5、GLM-4 这类不原生输出思维链的模型,也可以通过 prompt 技巧让 Agent"模拟"思考过程:
ReActAgent agent = ReActAgent.builder()
        .name("thinking-bot")
        .sysPrompt("""
                你是一个擅长"边想边说"的 AI 助手。

                在回答用户问题之前,请先进行内部推理。推理过程用以下格式包裹:

                <thinking>
                在这里写出你的推理过程、考虑的方案、对比的权衡
                </thinking>

                推理完成后,再给出最终回答。

                示例:
                用户:Java 中 List 和 Set 有什么区别?
                <thinking>
                List 和 Set 都是 Collection 的子接口...
                它们的主要区别在于:List 是有序可重复的...
                用户可能想了解使用场景的选择...
                </thinking>

                List 和 Set 的主要区别有以下几点:
                1. 有序性:...
                """)
        .model(model)
        .build();
然后在前端监听 TEXT_BLOCK_DELTA,检测到 <thinking> 标签就切换到"思考模式"渲染:
// 一个简单的思考模式解析器
public class ThinkingModeParser {
    private static final Pattern THINKING_PATTERN =
            Pattern.compile("<thinking>(.*?)</thinking>", Pattern.DOTALL);

    public static List<Segment> parse(String text) {
        List<Segment> segments = new ArrayList<>();
        Matcher matcher = THINKING_PATTERN.matcher(text);
        int lastEnd = 0;

        while (matcher.find()) {
            // 思考之前的文本(如果有)
            if (matcher.start() > lastEnd) {
                segments.add(new Segment(
                        text.substring(lastEnd, matcher.start()),
                        SegmentType.TEXT));
            }
            // 思考内容
            segments.add(new Segment(matcher.group(1), SegmentType.THINKING));
            lastEnd = matcher.end();
        }
        // 剩余文本
        if (lastEnd < text.length()) {
            segments.add(new Segment(text.substring(lastEnd), SegmentType.TEXT));
        }
        return segments;
    }

    enum SegmentType { TEXT, THINKING }
    record Segment(String content, SegmentType type) {}
}
注意:用 prompt 模拟的思维链和模型原生的 ThinkingBlock 有一个本质区别——原生 ThinkingBlock 事件在事件流中是独立的事件类型,可以被
THINKING_BLOCK_DELTA单独捕获。而 prompt 模拟的思维链只是普通文本,你需要自己解析。效果上原生方式更优雅,prompt 方式更通用。
4. 实战:带思考流的"深度搜索"对话机器人
把上面的知识点串起来,我们来构建一个"高端大气上档次"的对话机器人——它会在回答问题前先展示思考过程,然后给出完整的回答,并且支持多轮对话:
package com.example;

import com.example.tools.WebSearchTool; // 假设有一个网页搜索工具
import io.agentscope.core.ReActAgent;
import io.agentscope.core.event.*;
import io.agentscope.core.message.UserMessage;
import io.agentscope.core.tool.Toolkit;
import io.agentscope.extensions.model.openai.OpenAIChatModel;
import io.agentscope.extensions.model.openai.OpenAIChatFormatter;

/**
 * 带思考流的深度对话机器人 Demo
 * 使用 DeepSeek-R1 等推理模型演示 ThinkingBlock 事件
 */
public class DeepThinkingBot {

    public static void main(String[] args) {
        // 使用推理模型(支持原生思维链)
        OpenAIChatModel model = OpenAIChatModel.builder()
                .apiKey(EnvUtil.getSiliconApiKey())
                .baseUrl("https://api.siliconflow.cn")
                .endpointPath("/v1/chat/completions")
                .modelName("Qwen/Qwen3-8B")
                .stream(true)                    // ← 流式输出开关
                .formatter(new OpenAIChatFormatter())
                .build();
        // ToolKit 添加网络搜索工具
        Toolkit toolkit = new Toolkit();
        toolkit.registerTool(new WebSearchTool());


        // 构建 Agent
        ReActAgent agent = ReActAgent.builder()
                .name("deep-thinker")
                .sysPrompt("你是一个深度思考助手。面对复杂问题,你会:\n" +
                        "1. 先展示完整的推理过程\n" +
                        "2. 如果需要实时信息,调用搜索工具\n" +
                        "3. 给出最终答案时引用推理中的关键结论")
                .model(model)
                .toolkit(toolkit)
                .maxIters(10)
                .build();

        // 发起查询——展示完整思考 + 搜索 + 回答过程
        agent.streamEvents(new UserMessage(
                        "AgentScope Java 2.0 相比 1.x 版本有哪些重要的架构改进? 官方文档地址为:https://java.agentscope.io/v2/zh/docs/index.html"))
                .doOnNext(event -> {
                    switch (event.getType()) {
                        case AGENT_START -> System.out.println("🚀 开始分析问题...\n");

                        case THINKING_BLOCK_START -> System.out.println("┌─ 🤔 深度思考中 ─────────────────────┐");

                        case THINKING_BLOCK_DELTA -> {
                            // 思考内容——用灰色斜体展示
                            String thought = ((ThinkingBlockDeltaEvent) event).getDelta();
                            System.out.print("\u001B[90m" + thought + "\u001B[0m");
                        }

                        case THINKING_BLOCK_END -> System.out.println("\n└────────────────────────────────────┘\n");

                        case TOOL_CALL_START -> {
                            String toolName = ((ToolCallStartEvent) event).getToolCallName();
                            System.out.println("🔍 [正在搜索] " + toolName + " ...");
                        }

                        case TOOL_RESULT_TEXT_DELTA -> {
                            String toolOutput = ((ToolResultTextDeltaEvent) event).getDelta();
                            System.out.println("\n\u001B[90m━━━ 搜索结果 ━━━\u001B[0m\n" + toolOutput);
                        }

                        case TEXT_BLOCK_DELTA -> System.out.print(((TextBlockDeltaEvent) event).getDelta());

                        case AGENT_END -> System.out.println("\n\n✅ 分析完成!");
                    }
                })
                .blockLast();
    }
}
这段代码输出效果大概是这样的:

从上面的执行过程也可以看到,Agent 在发现自己的知识可能不完整时,主动去搜索了最新信息,然后继续推理,虽然我演示使用的工具搜索出现了查询抄手问题,但整体的执行链路还是完整的ReAct 循环 + 推理模型的完美配合——思考触发行动,行动结果反哺思考,最终给出答案。
六、Builder 模式的最佳实践与陷阱
1. 推荐:用工厂方法封装 Builder
直接在业务代码里写 HarnessAgent.builder().xxx.build() 虽然灵活,但会导致配置散落各处。推荐用工厂方法封装:
/**
 * Agent 工厂 —— 统一管理 Agent 的创建
 */
public class AgentFactory {

    private static final Model DEFAULT_MODEL = OpenAIChatModel.builder()
            .apiKey(EnvUtil.getSiliconApiKey())
            .baseUrl("https://api.siliconflow.cn")
            .endpointPath("/v1/chat/completions")
            .modelName("Qwen/Qwen2.5-7B-Instruct")
            .stream(true)
            .formatter(new OpenAIChatFormatter())
            .build();

    /**
     * 创建纯对话机器人(无工具)
     */
    public static ReActAgent createChatBot(String name, String personality) {
        return ReActAgent.builder()
                .name(name)
                .sysPrompt("你是一个" + personality + "。" +
                        "你会记住对话历史,基于上下文自然地回答问题。")
                .model(DEFAULT_MODEL)
                .maxIters(3)
                .build();
    }

    /**
     * 创建带工具的智能助手
     */
    public static HarnessAgent createToolAgent(
            String name, String prompt, Toolkit toolkit) {
        return HarnessAgent.builder()
                .name(name)
                .sysPrompt(prompt)
                .model(DEFAULT_MODEL)
                .toolkit(toolkit)
                .workspace(Paths.get(".agentscope", "workspace", name))
                .build();
    }

    /**
     * 创建推理型 Agent(带思考模式 + 计划能力)
     */
    public static HarnessAgent createReasoningAgent(
            String name, String prompt, Toolkit toolkit) {
        return HarnessAgent.builder()
                .name(name)
                .sysPrompt(prompt + "\n在回答复杂问题前,请先展示你的思考过程。")
                .model(DEFAULT_MODEL)
                .toolkit(toolkit)
                .enablePlanMode()
                .workspace(Paths.get(".agentscope", "workspace", name))
                .build();
    }
}

// 使用 —— 一行代码创建 Agent
ReActAgent chatBot = AgentFactory.createChatBot("assistant", "友善的 Java 技术顾问");
HarnessAgent toolAgent = AgentFactory.createToolAgent("searcher", "...", toolkit);
2. 陷阱:Builder 不是"用完即弃"的
很多小伙伴会写出这样的代码:
// ❌ 错误用法:每次都构建新的 Model 对象
public void chat(String message) {
    var model = OpenAIChatModel.builder()
            .apiKey(getApiKey())
            .modelName("qwen-plus")
            .stream(true)
            .build();

    var agent = HarnessAgent.builder()
            .name("bot")
            .model(model)       // ← 每次调用都新建 model
            .build();

    agent.call(new UserMessage(message)).block();
}
Model 对象是线程安全的,可以复用。每次调用都新建 Model 会造成不必要的对象创建和连接开销。正确姿势是把 Model 提取为成员变量或者单例:
// ✅ 正确用法:Model 复用
private static final Model MODEL = OpenAIChatModel.builder()
        .apiKey(EnvUtil.getApiKey())
        .modelName("qwen-plus")
        .stream(true)
        .build();

public void chat(String message) {
    var agent = HarnessAgent.builder()
            .name("bot")
            .model(MODEL)     // ← 复用
            .build();
    agent.call(new UserMessage(message)).block();
}
3. 陷阱:Builder 不会校验配置的正确性
Builder 模式有一个"先天弱点":所有的配置校验都是在 build() 方法中才执行的。这意味着你可能直到运行时才发现配置错了。
// 编译通过,运行时炸了
HarnessAgent agent = HarnessAgent.builder()
        .name("")                          // 空名称
        .model((Model) null)               // 空模型
        .maxContextTokens(-1)              // 负数 Token
        .build();                          // 抛出 IllegalArgumentException
建议在构建 Agent 时,总是 try-catch 包一下,或者在工厂方法中加入前置校验:
public static HarnessAgent createSafely(String name, Model model) {
    Objects.requireNonNull(name, "Agent name must not be null");
    Objects.requireNonNull(model, "Model must not be null");
    if (name.isBlank()) {
        throw new IllegalArgumentException("Agent name must not be blank");
    }

    return HarnessAgent.builder()
            .name(name.trim())
            .model(model)
            .build();
}
七、小结
到这里,关于 AgentScope Java 2.0 的 Builder 模式、流式输出和思考模式,我们已经有了完整的认识。回顾一下今天的核心内容:
1. Builder 模式的设计哲学
- Agent 有大量可选配置项,Builder 模式让代码可读、安全、灵活
- Builder 链把"我要什么"说清楚,不关心"怎么拼起来"
- 纯 Java 实现,不绑定 Spring,在任何环境下都能使用
2. 流式输出全解析
streamEvents()覆盖 Agent 执行的完整生命周期- 6 类核心事件:AgentStart / ThinkingBlock / TextBlock / ToolCall / ToolResult / AgentEnd
- 通过事件类型分发,可以实现类似 ChatGPT 的流式打字效果
3. 思考模式(Thinking Mode)
- ThinkingBlock 事件= 模型原生思维链(需推理模型支持)
- Prompt 模拟思考= 通过
<thinking>标签让普通模型展示推理过程 - 思考 + 行动 + 再思考 = ReAct 循环与思维链的完美协同
4. 最佳实践
- 用工厂方法封装 Builder 创建逻辑
- Model 对象线程安全,可以复用
- 在
build()之前做好参数校验
最后放一张对比表,帮大家快速选择:
| 场景 | 推荐 Agent | Builder 关键配置 |
|---|---|---|
| 纯对话聊天 | ReActAgent | .model(xxx).stream(true).maxIters(3) |
| 带工具的助手 | ReActAgent / HarnessAgent | .model().toolkit().maxIters(10) |
| 需要记忆持久化 | HarnessAgent | .workspace().model() |
| 深度推理 + 搜索 | HarnessAgent | .model(推理模型).toolkit().enablePlanMode() |
| Web 后端对接 | HarnessAgent | .workspace().middleware().streamEvents() |
八、其他
0. 项目
- 项目地址:https://github.com/liuyueyi/spring-ai-demo/agent-scope
- Builder 模式官方示例:https://java.agentscope.io/v2/zh/docs/harness/workspace.html
- 消息与事件系统:https://java.agentscope.io/v2/zh/docs/building-blocks/message-and-event.html
- Agent 创建与配置:https://java.agentscope.io/v2/zh/docs/building-blocks/agent.html
1. 下篇预告
本文是【AgentScope Java 新手村系列】的第三篇。回顾一下系列进度:
- ✅ 第1篇:简介与环境搭建:从零搭环境,跑通第一个 Agent 对话
- ✅ 第2篇:ReActAgent 核心拆解:理解"思考→行动→观察"的推理循环
- ✅ 第3篇:你的第一个 Java Agent:Builder 模式全面解析 + 流式输出 + 思考模式
- 🔜 第4篇:工具系统(Tools)实战 —— 用
@Tool注解将任意 Java 方法注册为 Agent 工具,实现文件读写、HTTP 调用、数据库查询等骚操作 - 🔜 第5篇:结构化输出 —— 让 Agent 直接返回指定的 Java 类型数据
今天讲完了 Builder 模式和流式输出的全貌,不知道各位小伙伴有没有注意到一个细节——ThinkingBlock 事件其实是"模型内部的思考",而 @Tool 注解的注册是"Agent 在框架层面的行动"。这两者一个对内、一个对外,构成了 Agent 完整的心智模型。
那么问题来了——工具到底怎么定义?@Tool 注解的参数有哪些讲究?工具调用失败后 Agent 会自动重试吗?这些内容,我们下一篇再详细介绍。
尽信书则不如,以上内容,纯属一家之言,因个人能力有限,难免有疏漏和错误之处,如发现 bug 或者有更好的建议,欢迎批评指正,不吝感激。
微信公众号: 一灰灰Blog —— 关注获取最新技术文章推送