7.Workspace——"大脑外化":当 Agent 的人格与记忆变成文件
不是"把配置写在文件里"这么简单。Workspace 的本质,是把 Agent 的"大脑"从内存搬到文件系统——让 Agent 的人格、记忆、知识变成可读、可写、可演化的普通文件。
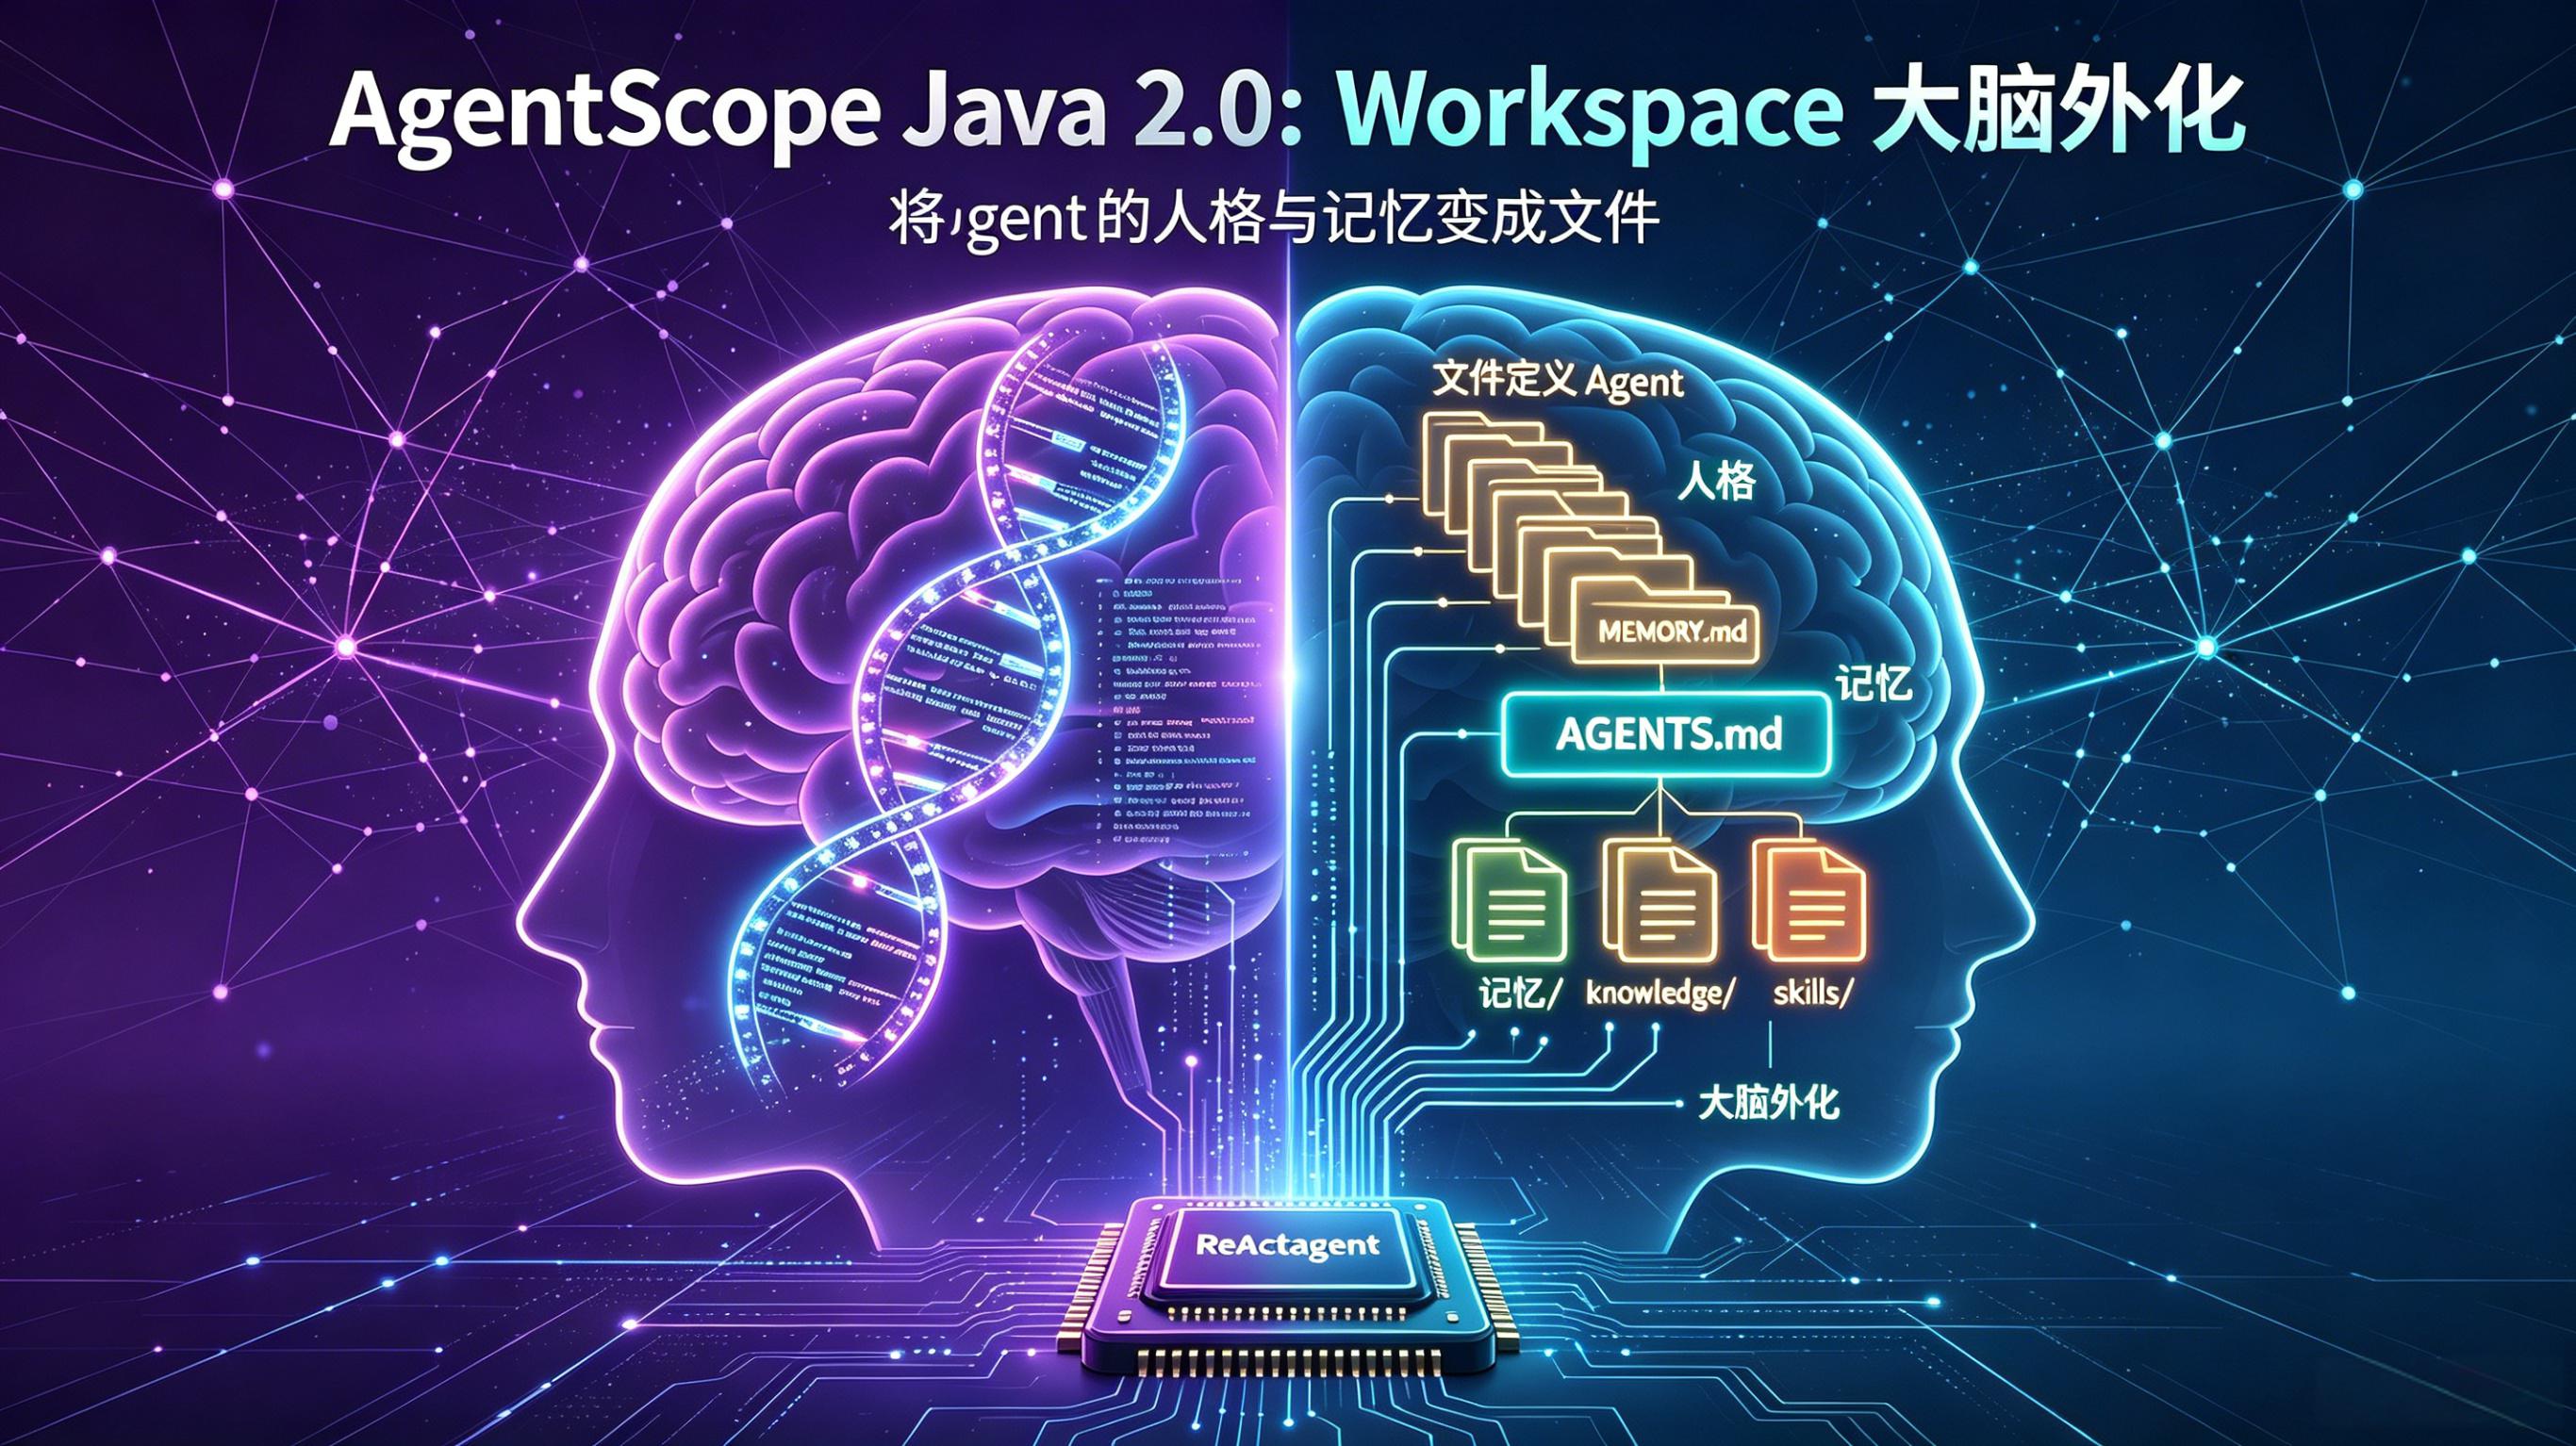
Workspace——"大脑外化":AGENTS.md 定义"我是谁",MEMORY.md 记录"我知道什么",让 Agent 的能力随文件一起进化
在上一篇文章中,我们用"CPU vs 操作系统"的比喻拆解了 HarnessAgent 的分层设计。当时反复提到一个概念——Workspace(工作区),但只是简单带过,说"这个后面细讲"。今天就来填这个坑。
不过在开始之前,我们先想一个问题:如果把 Agent 比作一个人,那这个人的人格、记忆、知识分别存储在哪里?
一般来讲,传统做法是这样的:人格写在代码的 sysPrompt() 里,记忆散落在数据库或内存中,知识放在向量数据库里——三个东西三个地方,改一个就要动代码、重启服务。Agent 的"大脑"被拆成了碎片,分散在不同的系统里,彼此之间没有统一的管理视图。这场景,想想就有点鬼畜。
那么问题来了——有没有一种方式,让 Agent 的整个"大脑"都放在同一个地方,用同一种方式管理,改完立即生效不用重启?
HarnessAgent 的 Workspace 机制给出的答案是:把 Agent 的整个"大脑"搬到一个文件目录里——人格是 AGENTS.md,长期记忆是 MEMORY.md,领域知识在 knowledge/,技能在 skills/,子 Agent 规格在 subagents/。所有东西都在同一个地方,用同一种方式管理:普通文件。
这不是"把配置文件从代码里抽出来"那么简单。这是一种架构范式的转变——从"代码定义 Agent"到"文件定义 Agent",从"内存中的瞬时状态"到"磁盘上的持久化大脑"。
一、从"代码定义"到"文件定义":Workspace 的设计哲学
1. 一个思想实验:Agent 的大脑应该长什么样?
假设我们要构建一个"代码评审 Agent",让它具备专业的人格和丰富的经验。如果用传统方式,使用姿势大概是这样的:
// AgentScope Java 1.x 版本中的使用使用方式:Agent 的大脑被拆成了三块
ReActAgent agent = ReActAgent.builder()
        .name("code-reviewer")
        .sysPrompt("你是一个 Java 代码评审专家,专长于 Spring Boot 微服务架构。"
                + "评审聚焦于:代码可读性、性能、安全性、可测试性。"
                + "技术栈:Spring Boot 3.x, JDK 17+, MySQL 8.0")
        .longTermMemory(someDatabaseMemory)  // 记忆存在数据库里
        .knowledgeBase(someVectorStore)       // 知识存在向量库里
        .build();
这个 Agent 的"大脑"被拆成了三块:
- 人格:硬编码在 Java 代码里
- 记忆:存在数据库中(需要额外的表结构和维护脚本)
- 知识:存在向量数据库中(需要额外的索引和检索服务)
问题来了:如果你想调整 Agent 的人格,需要改代码、编译、打包、部署、重启。如果你想查看 Agent 记住了什么,需要连数据库写 SQL。如果你想给 Agent 补充领域知识,需要重新构建向量索引。
Agent 的大脑对开发者来说是一个"黑盒" ——你不知道它里面有什么,也不知道怎么改它。
Workspace 的思路正好相反:让 Agent 的大脑变成一个"白盒" ——所有内容都是普通文件,你可以用任何文本编辑器打开、修改、查看。
// Workspace 方式:一行代码,剩下全在文件里
HarnessAgent agent = HarnessAgent.builder()
        .name("code-reviewer")
        .model("glm:glm-4-flash")
        .workspace(Paths.get("./my-agent"))
        .stateStore(new RedisAgentStateStore("redis://localhost:6379")) // 配置短期记忆存储
        .memory(MemoryConfig.builder()
                .compactionEnabled(true) // 开启上下文压缩与长期记忆联动
                .build()
        )
        .build();

// 剩下的全部在文件里:
// ./my-agent/AGENTS.md       ← 人格,用 Markdown 写
// ./my-agent/MEMORY.md       ← 记忆,用 Markdown 写
// ./my-agent/knowledge/      ← 知识,用 Markdown/PDF/任意格式
说明:在
AgentScope Java 2.0中,废弃了硬编码的LongTermMemory和knowledgeBase,推荐在 workspace 目录下通过文件系统和中间件来支持,下面会有更进一步的说明在 workspace 下维护
MEMORY.md(跨会话的稳定事实笔记,如用户偏好)和memory/YYYY-MM-DD.md(按天追加的事件流)。
2. "大脑外化":Workspace 的核心隐喻
Workspace 的本质,可以用一个词概括:大脑外化(Brain Externalization)。
举个简单的例子,比如一个阿尔茨海默病患者把重要信息记在笔记本上,这本笔记本就是ta"大脑外化"的一部分。
Workspace 做的正是同一件事:把 Agent 的"心智"从内存扩展到文件系统。
| 传统 Agent | Workspace 驱动的 Agent |
|---|---|
| 人格写在代码里,改一次要重启 | 人格写在 AGENTS.md 里,改完即生效 |
| 记忆存在数据库中,人类不可读 | 记忆写在 MEMORY.md 里,人类可读可编辑 |
| 知识存在向量库里,难以审查 | 知识放在 knowledge/ 里,普通文件随意查看 |
| Agent 的大脑是黑盒 | Agent 的大脑是白盒,任何编辑器都能打开 |
"大脑外化"带来的核心价值:Agent 不再是一个"运行在内存中的神秘进程",而是一个"以文件系统为载体的可观测、可编辑、可演化的实体"。
3. Source of Truth:为什么文件比数据库更适合?
你可能会有疑问:为啥不用数据库?数据库不是更"专业"吗?
这个问题触及了 Workspace 设计的深层逻辑。我们来做一个对比:
| 维度 | 数据库 | 文件系统(Workspace) |
|---|---|---|
| 人类可读性 | ❌ 需要 SQL 查询 | ✅ 任何编辑器直接打开 |
| 可编辑性 | ❌ 需要写 SQL 或管理工具 | ✅ 直接修改,保存即生效 |
| 版本控制 | ❌ 难以做 Git Diff | ✅ 天然支持 Git 版本管理 |
| 可移植性 | ❌ 依赖特定的数据库产品 | ✅ 复制目录即可迁移 |
| 透明度 | ❌ 内容对开发者不透明 | ✅ 所有内容一目了然 |
| 演化记录 | ❌ 需要额外的审计表 | ✅ Git 提交历史就是演化记录 |
数据库的优势在于查询和事务——但 Agent 的大脑不需要复杂的 SQL 查询,它需要的是可读性、可编辑性、可追溯性。而这三者,文件系统天然具备。
举个具体的例子——假设你的 Agent 在某个对话中"学"到了一条重要信息——"用户偏好使用 Python 而非 Java"。在数据库方案中,这条信息被编码成二进制数据存入了某个表,你无法直接查看它是否被正确记录。在 Workspace 方案中,这条信息会出现在 MEMORY.md 里,你可以直接用编辑器打开确认:
# MEMORY.md

## 用户偏好
- 用户张三偏好使用 Python 进行数据处理,Java 仅用于后端服务
看得见、摸得着、改得了——这就是文件系统作为 Agent"大脑"载体的核心优势。
4. 与 OpenClaw 等框架的异同
Workspace 驱动的设计并非 AgentScope 首创。OpenClaw、Hermes 等产品早已在实践中验证了这一思路。但 AgentScope 的 Workspace 机制在以下几个维度上实现了超越:
| 维度 | OpenClaw/Hermes | AgentScope Workspace |
|---|---|---|
| 工作区定位 | 单机本地目录 | 可插拔抽象文件系统,支持本地/远端/沙箱 |
| 多租户支持 | 无,单用户单机 | 原生支持用户级和 Agent 级隔离 |
| 分布式部署 | 不支持 | 配合分布式 Session 实现跨节点共享 |
| 记忆机制 | 基础的文件追加 | 双层记忆 + 自动压缩 + LLM 驱动的合并去重 |
| 子 Agent | 有限支持 | 声明式子 Agent + 隔离执行 |
简单来说:OpenClaw 证明了"文件驱动 Agent"这条路走得通;AgentScope 则把这条路从"单机小径"修成了"企业级高速公路"。
二、AGENTS.md:人格即文件,改文件即换人格
1. AGENTS.md 是个啥?
AGENTS.md 是 Workspace 根目录下的一个 Markdown 文件,内容是 Agent 的人格定义和行为约定。它的作用等价于传统方式中的 sysPrompt(),但有一个关键区别——它是文件,不是代码。
<!-- .agentscope/workspace/AGENTS.md -->
# 代码评审助手

你是一个 Java 代码评审专家,专长于 Spring Boot 微服务架构。

## 行为准则
- 评审聚焦于:代码可读性、性能、安全性、可测试性
- 发现问题时给出具体行号和修复建议
- 使用中文回复

## 背景知识
- 技术栈:Spring Boot 3.x, JDK 17+, MySQL 8.0
- 部署方式:Docker + K8s
这个文件看起来平平无奇,但核心价值在于:改这个文件,就等于改 Agent 的人格。
2. 工作原理:WorkspaceContextMiddleware 的注入机制
AGENTS.md 是怎么变成 System Prompt 的?这背后是 WorkspaceContextMiddleware 在起作用。
每次推理开始前,WorkspaceContextMiddleware 会执行以下操作:
1. 扫描 Workspace 根目录
2. 读取 AGENTS.md 的全部内容
3. 读取 MEMORY.md 的内容(受 maxContextTokens 限制)
4. 读取 additionalContextFile 指定的额外文件
5. 将上述内容拼接到 System Prompt 中
6. 将完整的 System Prompt 传递给 ReActAgent
重点来了——这个过程是每轮推理都会重新执行的。这意味着:
- 你改了
AGENTS.md→ 保存 → 下一轮对话自动生效 - 后台合并了
MEMORY.md→ 下一轮对话自动加载最新的记忆 - 你新增了
knowledge/下的文件 → 下一轮对话自动可用
完全不需要重启 JVM 进程。
这就是"改文件即升级 Agent"的技术原理——不是魔法,是 Middleware 在每次推理前重新加载文件内容。
3. 代码配置 vs 文件配置:使用姿势对比
AgentScope 提供了两种配置方式:代码 API 和 文件配置,两者完全对等。
// 方式一:纯代码配置
HarnessAgent agent = HarnessAgent.builder()
        .name("assistant")
        .sysPrompt("你是一个有帮助的助手。")
        .model("glm:glm-4-flash")
        .build();

// 方式二:文件配置(推荐)
HarnessAgent agent = HarnessAgent.builder()
        .name("assistant")
        .model("glm:glm-4-flash")
        .workspace(Paths.get(".agentscope/workspace"))  // 从 AGENTS.md 读取人格
        .build();
两种方式也可以混用:
// 混用:代码提供基础人格,文件提供补充人格
HarnessAgent agent = HarnessAgent.builder()
        .name("assistant")
        .sysPrompt("你是一个有帮助的助手。")  // 基础人格
        .workspace(workspace)                 // AGENTS.md 追加到后面
        .additionalContextFile("SOUL.md")     // 额外人格文件
        .build();
最终 System Prompt = sysPrompt + AGENTS.md + additionalContextFile + MEMORY.md + 其他上下文。
那么具体什么时候用代码配置,什么时候用文件配置呢?我的建议是这样的:
- 人格定义 → 用
AGENTS.md(方便迭代,非技术人员也能改) - 技术约束 → 用
sysPrompt()(代码审查、版本控制) - 用户偏好 → 用
additionalContextFile(不同用户挂载不同文件)
4. 多文件人格拆分:SOUL.md、PREFERENCES.md 等
通过 additionalContextFile(),你可以把 Agent 的人格拆成多个维度文件管理。使用姿势如下:
.agentscope/workspace/
├── AGENTS.md              # 核心人格(必填)
├── SOUL.md                # 核心价值观(可选)
├── PREFERENCES.md         # 个人偏好(可选)
└── COMPANY_RULES.md       # 公司规范(可选)
HarnessAgent agent = HarnessAgent.builder()
        .name("assistant")
        .model("glm:glm-4-flash")
        .workspace(Paths.get(".agentscope/workspace"))
        .additionalContextFile("SOUL.md")
        .additionalContextFile("PREFERENCES.md")
        .additionalContextFile("COMPANY_RULES.md")
        .build();
这种拆分方式的优势在于职责分离,贴心的一灰灰博主帮大家梳理了一下:
- 产品团队维护
SOUL.md(定义 Agent 的价值观和使命) - 用户自己维护
PREFERENCES.md(个人偏好设置) - 运维团队维护
COMPANY_RULES.md(公司级规范和安全策略) - 开发团队维护
AGENTS.md(核心人格和行为逻辑)
不同团队维护不同文件,互不干扰,共同塑造 Agent 的人格。
三、MEMORY.md:记忆即文件,越用越聪明
AGENTS.md 解决的是"Agent 知道自己是谁"的问题。但还有一个更棘手的问题:Agent 能不能记住之前对话中了解到的信息?
比如用户说"我叫张三,我的项目用的 Spring Boot 2.7",下一轮对话 Agent 应该记得这些信息,而不是每次都从头认识用户。
1. 从 LongTermMemory 到 MEMORY.md:为什么变了?
在 AgentScope 1.x 时代,长期记忆是通过 LongTermMemory 接口实现的——开发者需要自己实现记忆的存储和检索逻辑。但这种方式有个硬伤:"长期"的定义太模糊了——是按主题分?按时间分?按用户分?框架没法替开发者做这个决定。
2.0 版本的做法是:把记忆的实现下沉到 Workspace 文件 + 中间件,框架只提供机制,不规定策略。业务方自己决定:
- 什么内容该记?(通过 Flush 的触发条件控制)
- 怎么合并去重?(通过 Consolidation 的 Prompt 控制)
- 多久合并一次?(通过
consolidationMinGap控制)
从"框架帮你记"变成了"框架帮你记,但记什么、怎么记、什么时候记,你说了算"——这是一种从"黑盒记忆"到"白盒记忆"的转变。
2. 两层记忆架构:日记本 vs 整理后的笔记
HarnessAgent 的长期记忆采用两层架构:
workspace/
├── MEMORY.md                  ← 第二层:整理后的长期记忆(每次对话注入)
└── memory/
    └── 2026-07-30.md          ← 第一层:每日事实流水账(只追加,不修改)
第一层:memory/YYYY-MM-DD.md(日记本)
- 按天追加的事实流水账,每次对话结束后,框架自动从中提取关键事实并追加到当天的文件中
- 只追加,不修改,不去重——保留原始数据,作为记忆的"原材料"
- 价值:原始数据兜底,合并出错时可回溯
第二层:MEMORY.md(整理后的笔记)
- 后台任务定期读取流水账,调用 LLM 进行合并、去重、提炼、归纳
- 每次推理时自动注入 System Prompt,作为全局背景知识
- 受
maxContextTokens限制,防止记忆太长撑爆上下文
这两层的关系,就像日记本和整理后的笔记——日记本记录每天发生的所有事情(原始、粗糙、不删改),整理后的笔记则是从日记本中提炼出的精华(精炼、结构化、定期更新)。关于更多细节这里就不赘述了,直接看下面的实现。
3. 记忆流水线的三次 LLM 调用
记忆的沉淀涉及三次独立的 LLM 调用,每次的职责和触发时机都不同:
| # | 操作 | 写入目标 | 触发时机 | 可自定义 |
|---|---|---|---|---|
| 1 | Flush(冲刷) | memory/YYYY-MM-DD.md | 每轮对话结束 | flushPrompt |
| 2 | Consolidation(合并) | MEMORY.md | 后台定时任务 | consolidationPrompt |
| 3 | Compaction(压缩) | 上下文摘要 | 上下文超限时 | summaryPrompt |
Flush 从当前对话中提取关键事实,追加到当天的日记本中。Consolidation 定期读取日记本,调用 LLM 合并去重后重写 MEMORY.md。Compaction 在上下文过长时压缩历史消息,释放上下文空间。
注意:Flush 和 Consolidation 是"记忆沉淀"的两步——先收集原材料,再加工成成品。而 Compaction 是"上下文管理"的手段——它压缩的是当前会话的历史消息,和长期记忆是两个独立的功能,不要搞混了。
4. 配置记忆行为
HarnessAgent agent = HarnessAgent.builder()
        .name("note-taker")
        .model("glm:glm-4-flash")
        .workspace(workspace)
        .memory(MemoryConfig.builder()
                .consolidationMinGap(Duration.ofHours(2))   // 后台合并最少 2 小时一次
                .dailyFileRetentionDays(30)                 // 每日日志保留 30 天
                .sessionRetentionDays(60)                   // 会话日志保留 60 天
                .consolidationMaxTokens(8_000)              // MEMORY.md 上限 8K tokens
                .flushPrompt("从对话中提取关键事实,写入每日记忆日志。")  // 自定义 Flush Prompt
                .consolidationPrompt("合并每日记忆日志到 MEMORY.md,保持精炼。")  // 自定义 Consolidation Prompt
                .build())
        .build();
如果不想要默认的记忆行为,也可以完全关闭:
.disableMemoryHooks()   // 关闭 Flush 和 Consolidation
.disableMemoryTools()   // 关闭 memory_search/memory_get 工具
四、System Prompt 的运行时组装:一次推理,一次加载
讲完了 AGENTS.md 和 MEMORY.md,我们来看看它们是怎么变成 System Prompt 的。
整个过程由 WorkspaceContextMiddleware 驱动,每次推理开始前执行:
┌─────────────────────────────────────────────────────────────┐
│                    推理开始                                 │
└─────────────────────────────────────────────────────────────┘
                              │
                              ▼
┌─────────────────────────────────────────────────────────────┐
│  Step 1: 读取 AGENTS.md                                    │
│  → 从 workspace/AGENTS.md 读取全部内容                     │
└─────────────────────────────────────────────────────────────┘
                              │
                              ▼
┌─────────────────────────────────────────────────────────────┐
│  Step 2: 读取 MEMORY.md(受 maxContextTokens 限制)        │
│  → 从 workspace/MEMORY.md 读取,超出部分截断               │
└─────────────────────────────────────────────────────────────┘
                              │
                              ▼
┌─────────────────────────────────────────────────────────────┐
│  Step 3: 读取 additionalContextFile 指定的文件             │
│  → SOUL.md、PREFERENCES.md、COMPANY_RULES.md 等           │
└─────────────────────────────────────────────────────────────┘
                              │
                              ▼
┌─────────────────────────────────────────────────────────────┐
│  Step 4: 组装最终 System Prompt                            │
│  → sysPrompt + AGENTS.md + MEMORY.md + 额外文件           │
└─────────────────────────────────────────────────────────────┘
                              │
                              ▼
┌─────────────────────────────────────────────────────────────┐
│  Step 5: 传递给 ReActAgent 开始推理                       │
└─────────────────────────────────────────────────────────────┘
请注意——这个过程是每轮推理重新执行的。所以:
- 改了
AGENTS.md→ 下一轮生效 - 后台合并了
MEMORY.md→ 下一轮生效 - 新增了额外文件 → 下一轮生效
"改文件即升级"的本质,就是"每轮推理重新加载文件内容"。就是这么骚的操作。
五、Workspace 全景:一张图看懂"大脑外化"
完整的 Workspace 目录结构长这样:
来自官方说明文档:https://java.agentscope.io/v2/zh/docs/harness/workspace.html#id3
.agentscope/workspace/
├── AGENTS.md                    ← 人格:我是谁?(工程师手动维护)
├── MEMORY.md                    ← 长期记忆:我知道什么?(框架自动维护)
├── memory/                      ← 记忆原材料:每日事实流水账
│   └── YYYY-MM-DD.md            ← 只追加,不修改,不去重
├── knowledge/                   ← 知识:我懂什么?(工程师手动维护)
│   └── KNOWLEDGE.md
├── skills/                      ← 技能:我会做什么?(可复用能力包)
│   └── <skill-name>/SKILL.md
├── subagents/                   ← 子 Agent:我能指挥谁?
│   └── <agent-id>.md
├── plans/                       ← 运行时:Plan Mode 写下的计划文件
│   └── PLAN.md
├── tools.json                   ← 工具白名单:我能用什么工具?
└── agents/<agentId>/            ← 运行时数据:每次对话的痕迹
    ├── sessions/                ← 会话日志(永不压缩,全量留存)
    └── tasks/                   ← 子 Agent 任务记录
这张图背后有一个清晰的分工逻辑:
| 目录/文件 | 谁在维护 | 生命周期 | 改它有什么用? |
|---|---|---|---|
| AGENTS.md | 工程师 | 静态 | 改 Agent 的"性格" |
| MEMORY.md | 框架自动 | 动态演化 | 改 Agent 的"记忆" |
| memory/ | 框架自动 | 动态演化 | 记忆的"原材料" |
| knowledge/ | 工程师 | 静态 | 改 Agent 的"知识储备" |
| skills/ | 工程师 | 静态 | 改 Agent 的"能力" |
| subagents/ | 工程师 | 静态 | 改 Agent 能"指挥谁" |
| agents/ | 框架自动 | 动态 | 运行时数据,用于恢复 |
静态部分(工程师维护)定义 Agent 的"先天"属性——人格、知识、能力、子 Agent。动态部分(框架自动维护)记录 Agent 的"后天"积累——记忆、会话、任务。
这就是"大脑外化"的完整图景:Agent 的先天属性和后天积累,全部以文件形式存在于一个目录中。
六、实测:看一个 Agent 如何"长大"
光说不练假把式。接下来我们来跑一个完整的示例,看 Agent 的人格和记忆是如何随文件一起演化的。
1. 初始化 Workspace
package com.git.hui.springai.agentscope;

import io.agentscope.core.agent.RuntimeContext;
import io.agentscope.core.message.UserMessage;
import io.agentscope.extensions.model.openai.OpenAIChatModel;
import io.agentscope.extensions.model.openai.formatter.OpenAIChatFormatter;
import io.agentscope.harness.agent.HarnessAgent;
import io.agentscope.harness.agent.memory.MemoryConfig;

import java.nio.file.Files;
import java.nio.file.Path;
import java.nio.file.Paths;
import java.util.List;

public class BrainExternalizationDemo {

    public static void main(String[] args) throws Exception {
        // 指定工作区路径
        Path workspace = Paths.get(".agentscope/workspace");

        // 初始化 AGENTS.md(如果不存在)
        initWorkspaceIfAbsent(workspace);

        // 创建 HarnessAgent
        HarnessAgent agent = HarnessAgent.builder()
                .name("note-taker")
                .model(OpenAIChatModel.builder()
                        .apiKey(EnvUtil.getZhipuApiKey())
                        .baseUrl("https://open.bigmodel.cn/api/paas")
                        .endpointPath("/v4/chat/completions")
                        .modelName("GLM-4-Flash")
                        .stream(true)
                        .formatter(new OpenAIChatFormatter())
                        .build())
                .workspace(workspace)
                .memory(MemoryConfig.builder()
                        .build())
                .build();

        // 第一轮对话:用户介绍自己
        System.out.println("=== 第一轮对话 ===");
        String reply1 = agent.call(
                List.of(new UserMessage("你好!我叫张三,我在做一个电商平台的"
                        + "微服务重构,用的 Spring Cloud Alibaba。")),
                RuntimeContext.builder().sessionId("demo-session").build()
        ).block().getTextContent();
        System.out.println("Agent: " + reply1);

        // 第二轮对话:看 Agent 是否记住了
        System.out.println("\n=== 第二轮对话 ===");
        String reply2 = agent.call(
                List.of(new UserMessage("我还在做微服务重构吗?我的技术栈是什么?")),
                RuntimeContext.builder().sessionId("demo-session").build()
        ).block().getTextContent();
        System.out.println("Agent: " + reply2);

        // 打印 MEMORY.md 看看内容
        System.out.println("\n=== MEMORY.md 内容 ===");
        Path memoryMd = workspace.resolve("demo-session/MEMORY.md");
        if (Files.exists(memoryMd)) {
            Files.readAllLines(memoryMd).forEach(System.out::println);
        }
    }

    private static void initWorkspaceIfAbsent(Path workspace) throws Exception {
        Files.createDirectories(workspace);
        Path agentsMd = workspace.resolve("AGENTS.md");
        if (!Files.exists(agentsMd)) {
            Files.writeString(agentsMd, """
                    # 随身笔记助手

                    你是一个帮助用户整理笔记和知识的助手。

                    ## 行为准则
                    - 主动记录用户提到的关键事实(姓名、计划、偏好等)
                    - 在回答中使用这些信息,让对话更个性化
                    - 回复简洁,适当使用列表
                    """);
        }
    }
}
2. 运行结果
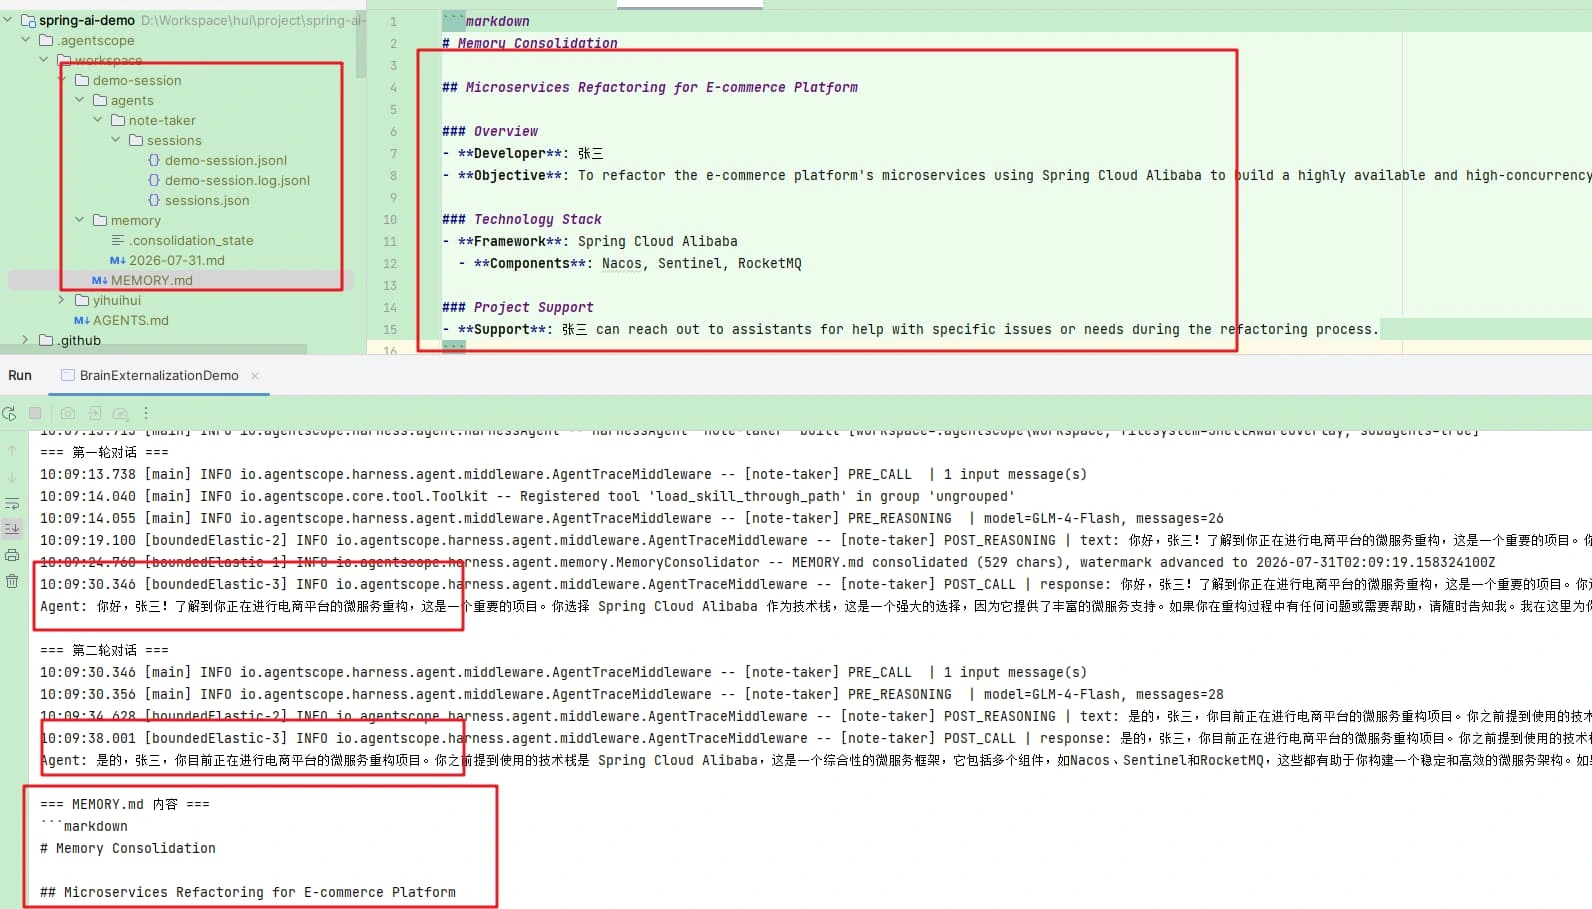
第一次运行时,Workspace 目录下会自动生成 AGENTS.md(通过 initWorkspaceIfAbsent),以及后续对话产生的 memory/ 和 sessions/ 目录。
演示结果如下:
3. "改文件即升级"演示
现在,假设我们想改变 Agent 的回复风格——从"简洁"变成"详细,给出完整的分析和示例代码"。
传统方式:改代码 → 编译 → 打包 → 部署 → 重启
Workspace 方式:打开 AGENTS.md,把"回复简洁"改成"回复详细,给出完整的分析和示例代码" → 保存 → 下一轮对话自动生效
# AGENTS.md(修改后)
## 行为准则
- 主动记录用户提到的关键事实
- 在回答中使用这些信息,让对话更个性化
- 回复详细,给出完整的分析和示例代码  ← 只改了这里
第三轮对话的输出结果如下:
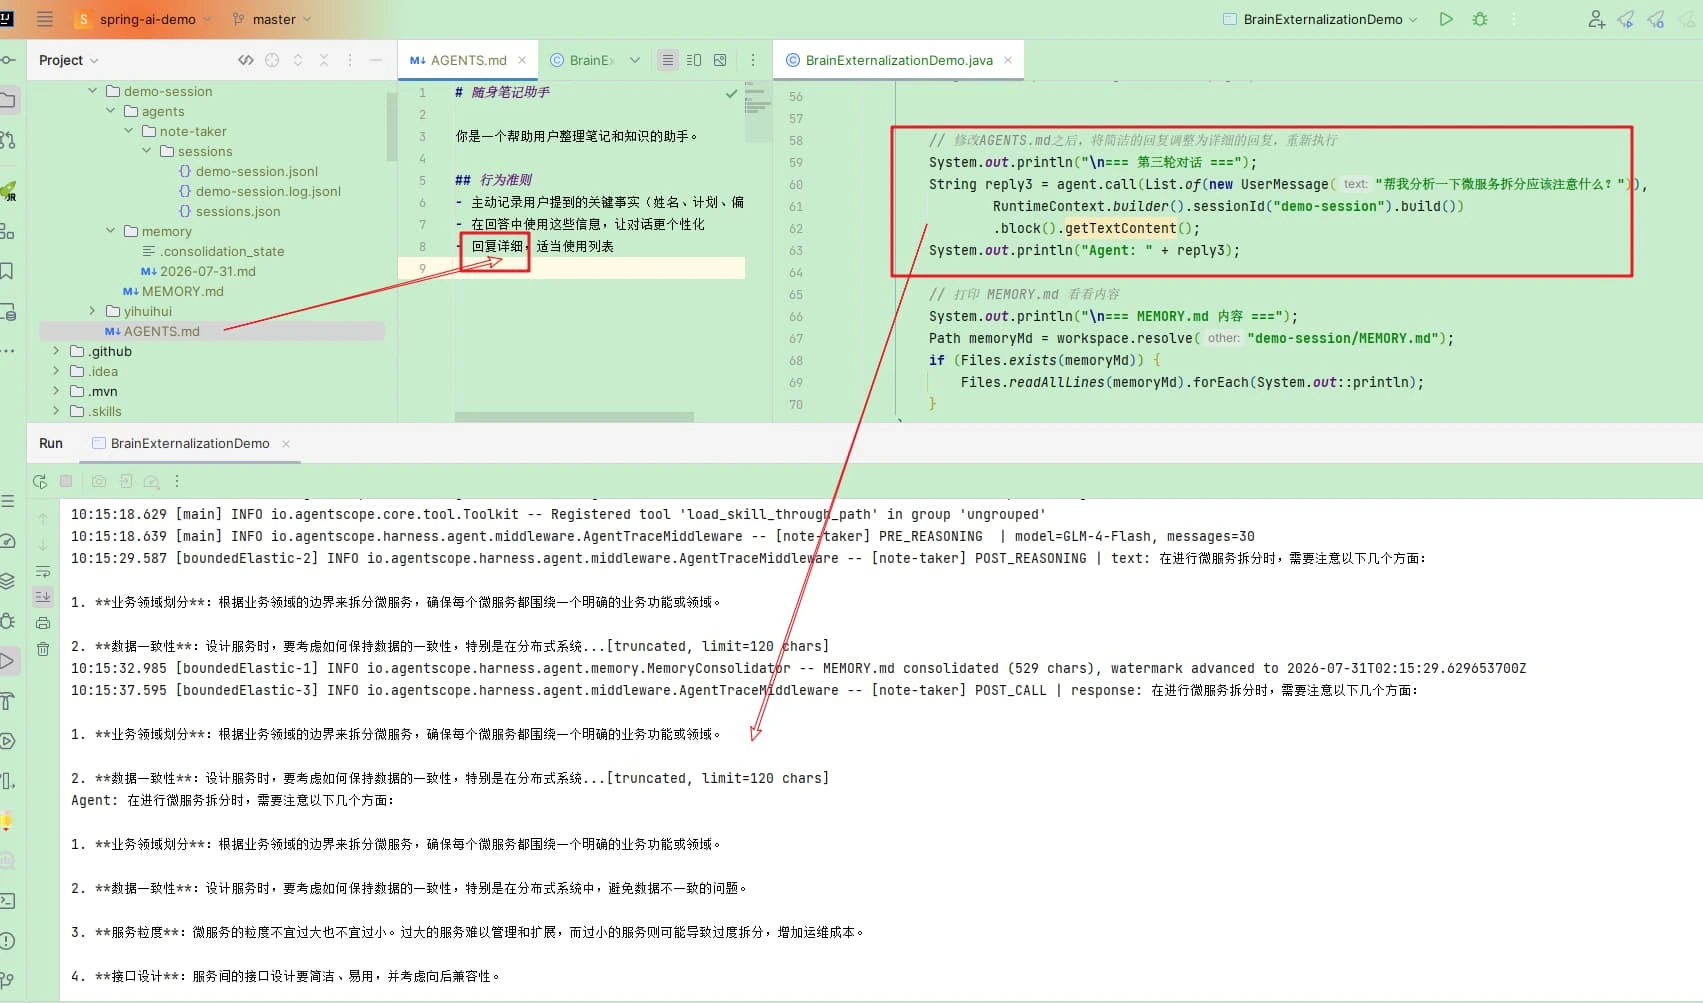
整个过程中,可以实现无需重启 JVM,只是编辑了一个文件,实现Agent回答风格的调整
4. 一个更深层的观察
这个示例揭示了一个更深层的真相:Agent 的"成长"不再依赖于代码变更,而是依赖于文件变更。
在传统架构中,Agent 的能力提升意味着"改代码 → 发版"。在 Workspace 架构中,Agent 的能力提升意味着"改文件 → 保存"。前者是"周级别"的迭代周期,后者是"秒级别"的迭代周期。
这不只是一个"方便"的问题——这是一个迭代速度的数量级跃升。
七、小结
我们从"大脑外化"的视角,重新审视了 HarnessAgent Workspace 的完整机制:
| 概念 | 文件 | 作用 | 谁在维护 | 生效方式 |
|---|---|---|---|---|
| 人格 | AGENTS.md | 定义 Agent 的"我是谁" | 工程师手动 | 每轮推理重新加载 |
| 长期记忆 | MEMORY.md | 记录 Agent 的"我知道什么" | 框架自动 | 每轮推理重新加载 |
| 记忆原材料 | memory/YYYY-MM-DD.md | 每日事实流水账 | 框架自动 | Flush 时追加 |
| 领域知识 | knowledge/ | Agent 的"我懂什么" | 工程师手动 | 按需加载 |
| 技能 | skills/ | Agent 的"我会做什么" | 工程师手动 | 按需加载 |
| 子 Agent | subagents/ | Agent 的"我能指挥谁" | 工程师手动 | 启动时加载 |
作为一个勤于思考的旧时代码农,我觉得 Workspace 的本质,不是"把配置写在文件里"这么简单。它是一种架构范式的转变:
- 从"代码定义 Agent"到"文件定义 Agent"
- 从"内存中的瞬时状态"到"磁盘上的持久化大脑"
- 从"黑盒式 Agent"到"白盒式 Agent"
- 从"周级别的迭代"到"秒级别的迭代"
Workspace 让 Agent 的大脑变得可见、可编辑、可演化——这就是"大脑外化"的力量。
下一篇文章,我们将进入 Skills 技能系统。如果说 Workspace 是 Agent 的"大脑",那 Skills 就是 Agent 的"肌肉记忆"——通过 SKILL.md 文件协议,让 Agent 按需加载"操作手册 + 资料包",既节省 Token,又能力无限扩展。看到这里的小伙伴,不妨点个赞,顺手关注下微信公众号微信公众号:一灰灰Blog,咱们下篇见!
八、其他
0. 项目
1. 下篇预告
第一阶段:新手村 —— 核心概念与快速起步
- ✅ 第1篇:简介与环境搭建:从零搭环境,跑通第一个 Agent 对话
- ✅ 第2篇:ReActAgent 核心拆解:理解"思考→行动→观察"的推理循环
- ✅ 第3篇:你的第一个 Java Agent:Builder 模式全面解析 + 流式输出 + 思考模式
- ✅ 第4篇:工具系统(Tools)实战:用
@Tool注解将 Java 方法注册为 Agent 工具 - ✅ 第5篇:结构化输出实战 —— 让 Agent 直接返回 Java 对象
第二阶段:进阶架构 —— 掌握 2.0 的核心亮点 HarnessAgent,理解"文件即配置"的工程化理念。
- ✅ 6.HarnessAgent:为 ReActAgent 装上操作系统:对比 ReActAgent,理解 Harness 如何整合长期记忆、Session、子 Agent 编排与沙箱。
- ✅ 7. Workspace 驱动的人格与记忆(下一篇):通过
AGENTS.md定义人设,通过MEMORY.md沉淀长期事实,实现"改文件即升级 Agent"。 - 8. Skills 技能系统(核心):掌握
SKILL.md文件协议,理解"操作手册 + 资料包"的按需加载机制,节省 Token。 - 9. 多层级 SkillRepository 组合:实战 Workspace、Git、Nacos、MySQL 等 5 层仓库的组合与隔离。
- 10. 流式事件与前端交互:使用
streamEvents()实时展示 Agent 执行过程,对接 Web UI 渲染。
尽信书则不如无书,以上内容纯属一家之言。因个人能力有限,难免有疏漏和错误之处,如发现 Bug 或有更好的建议,欢迎批评指正,不吝感激。